
Pythonで線形回帰を実行するだけなら、scikit-learnのLinearRegressionを使って数行で学習できます。しかし、実務で回帰分析の結果を読むには、「なぜその係数になったのか」「R²は何を表しているのか」「残差を見ると何が分かるのか」を理解しておくことが重要です。
線形回帰は、目的変数を説明変数の線形結合で表す基本的な回帰モデルです。通常最小二乗法(Ordinary Least Squares: OLS)では、観測値と予測値の差である残差の二乗和が最小になるように係数を推定します(Seber and Lee, 2003)。scikit-learnのLinearRegressionも、残差平方和を最小化する通常最小二乗法の線形回帰として実装されています(Pedregosa et al., 2011)。
この記事では、広告費と営業件数から売上を生成した360件の人工データを使い、単回帰の数式、最小二乗法、重回帰、回帰係数、決定係数R²、残差の順に確認します。記事内のデータと数値はすべて説明用に生成したもので、実在企業や実際の営業・広告活動とは関係ありません。
intercept_、coef_、R²、残差を数式と対応させると、回帰結果を「出力された数字」ではなく分析結果として読みやすくなります。線形回帰とはどのようなモデルか
単回帰の数式
説明変数が1つだけの線形回帰を単回帰と呼びます。例えば、広告費から売上を説明する場合、モデルはŷ = β₀ + β₁xと書けます。ŷは予測売上、xは広告費、β₀は切片、β₁は広告費に対する回帰係数です。
β₁が正なら、モデル上では広告費が増えるほど予測売上も増える関係になります。ただし、回帰係数が正であることは「広告費を増やせば必ず売上が増える」という因果関係を意味しません。観測データに含まれる関係を線形式として整理したものと考える必要があります。
重回帰の数式
説明変数が複数ある場合は重回帰になります。広告費と営業件数を使うなら、ŷ = β₀ + β₁ × 広告費 + β₂ × 営業件数と表せます。重回帰で広告費の係数β₁を読むときは、営業件数など他の説明変数を一定としたモデル上で、広告費が1単位増えたときに予測値がどの程度変化するかを見るのが基本です。
| 要素 | 意味 | 今回の例 |
|---|---|---|
| 目的変数 | 説明・予測したい結果 | 売上 |
| 説明変数 | 目的変数との関係を見る変数 | 広告費、営業件数 |
| 回帰係数 | 説明変数が1単位変化したときのモデル上の変化量 | β₁、β₂ |
| 切片 | 説明変数が0のときの予測値 | β₀ |
| 誤差項 | モデルでは表現されない理論上の変動 | ε |
理論上の誤差項εは観測できません。一方、実際のデータから計算できる「実測値-予測値」が残差です。誤差項と残差は関係していますが、厳密には同じものではありません。
線形回帰の係数はどう決まるのか
実測値と予測値の差が残差
あるデータ点について、実際の売上をyᵢ、モデルの予測値をŷᵢとすると、残差eᵢはeᵢ = yᵢ − ŷᵢです。残差が正ならモデルはそのデータを過小予測し、負なら過大予測しています。
なぜ残差を二乗するのか
残差をそのまま足すと、正の残差と負の残差が相殺されます。そこで通常最小二乗法では、それぞれの残差を二乗して合計したRSS = Σ(yᵢ − ŷᵢ)²を使います。二乗することで符号による相殺を防ぎ、大きな残差には相対的に大きなペナルティを与えられます。OLSはこの残差平方和が最小になる係数を求める方法です(Weisberg, 2005)。
単回帰の傾きと切片
切片を含む単回帰では、傾きβ₁と切片β₀はβ₁ = Σ[(xᵢ − x̄)(yᵢ − ȳ)] / Σ[(xᵢ − x̄)²]、β₀ = ȳ − β₁x̄で求められます。
今回の人工データでNumPyから計算すると、広告費係数は2.6339、切片は427.8660でした。scikit-learnで同じ単回帰を行った結果も同じ値になり、数式とライブラリの出力が対応していることを確認できます。
x = df["広告費_万円"].to_numpy()y = df["売上_万円"].to_numpy()beta1 = ((x - x.mean()) * (y - y.mean())).sum() / ((x - x.mean()) ** 2).sum()beta0 = y.mean() - beta1 * x.mean()from sklearn.linear_model import LinearRegressionmodel = LinearRegression()model.fit(df[["広告費_万円"]], df["売上_万円"])print(model.intercept_)print(model.coef_[0])この単回帰では営業件数を説明変数に入れていません。人工データの売上は広告費だけでなく営業件数からも生成されているため、単回帰の切片や係数を人工生成式の真の値と直接比較するのではなく、「手計算式とscikit-learnが同じ単回帰解を与える」ことを確認するのが目的です。
重回帰を行列で表すとどうなるか
説明変数が複数ある重回帰は、行列を使うとy = Xβ + εと表せます。条件が整っている場合、OLSの推定量は理論上β̂ = (XᵀX)⁻¹Xᵀyと書けます。ただし、実務コードでこの逆行列を直接計算することを標準的な方法として推奨するものではありません。数値計算ではより安定した解法が用いられます。
人工データで線形回帰をPython実装する
広告費・営業件数・売上の人工データ
今回の人工データは360件で、売上 = 300 + 2.5 × 広告費 + 4.0 × 営業件数 + ランダム誤差という生成式をベースにしています。単位は広告費・売上が万円、営業件数が件です。ランダム誤差も加えているため、すべての点が完全な平面上に並ぶわけではありません。
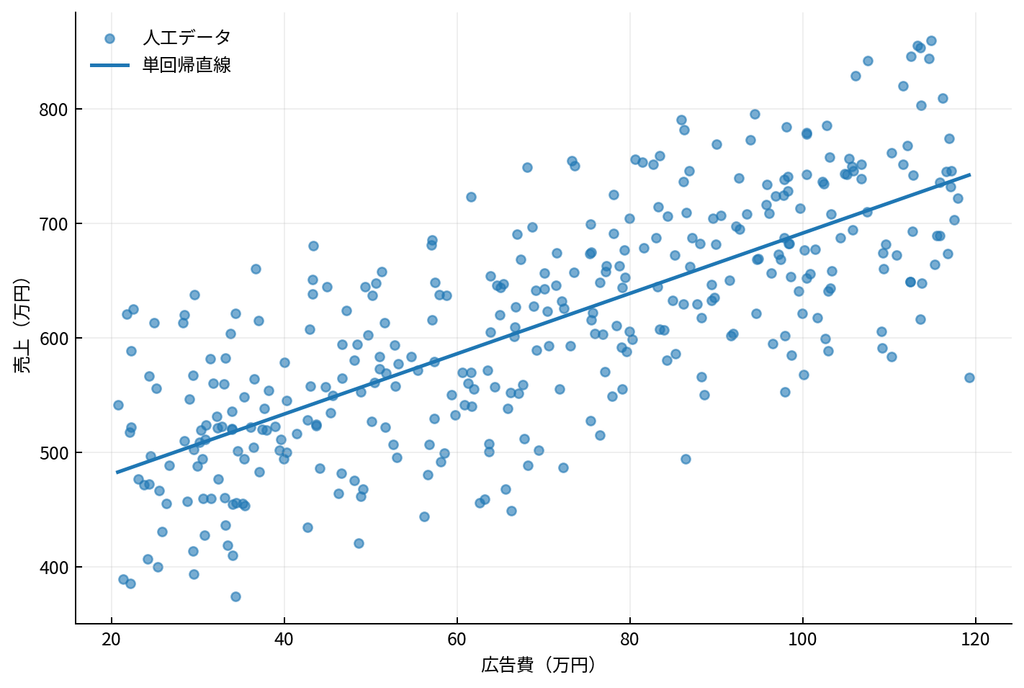
売上には営業件数とランダム誤差の影響も含まれるため、点は直線の周囲にばらつきます。
広告費と営業件数を使った重回帰
次に、広告費と営業件数の2変数を使って重回帰を行います。データの75%を学習用、25%をテスト用に分け、未知データに対する評価を行いました。
X = df[["広告費_万円", "営業件数_件"]]y = df["売上_万円"]model = LinearRegression()model.fit(X_train, y_train)pred = model.predict(X_test)residual = y_test - pred推定結果は、切片300.080、広告費係数2.588、営業件数係数3.751でした。人工生成時の設定値300、2.5、4.0に近い値が得られています。有限のデータにランダム誤差を加えているため、推定値が設定値と完全一致する必要はありません。
| 項目 | 人工データ設定値 | 推定値 |
|---|---|---|
| 切片 | 300.0 | 300.080 |
| 広告費 | 2.5 | 2.588 |
| 営業件数 | 4.0 | 3.751 |
回帰係数をどう解釈するか
広告費の推定係数は2.588でした。この人工データ上では、営業件数を一定としたモデル上で広告費が1万円増えると、予測売上が約2.588万円増える関係を表します。営業件数の推定係数3.751も、広告費を一定としたモデル上で営業件数が1件増えたときの変化量として読みます。
ここで重要なのは「モデル上で」という点です。観測データの回帰係数だけから、広告費や営業件数を実際に増やす施策の因果効果を確定することはできません。また、広告費は万円、営業件数は件で単位が異なるため、係数の絶対値だけを見て「営業件数の方が重要」と判断することも適切ではありません。
切片は、すべての説明変数が0のときのモデル予測値です。しかし、分析対象の範囲に広告費0万円・営業件数0件という状態がなければ、数式上の切片に強い業務的意味を持たせない方が安全です。
R²とは何か
決定係数R²は、目的変数の変動に対してモデルがどの程度説明できているかを見る代表的な指標です。一般にはR² = 1 − Σ(yᵢ − ŷᵢ)² / Σ(yᵢ − ȳ)²で表されます。分子はモデルの残差平方和、分母は実測値が平均との差として持つ全体の変動です。
- R² = 1:評価データに対して実測値と予測値が完全に一致する。
- R² = 0:その評価条件では、目的変数の平均値を常に予測する基準と同程度。
- R² < 0:評価データでは、平均値を予測する基準より残差平方和が大きい。
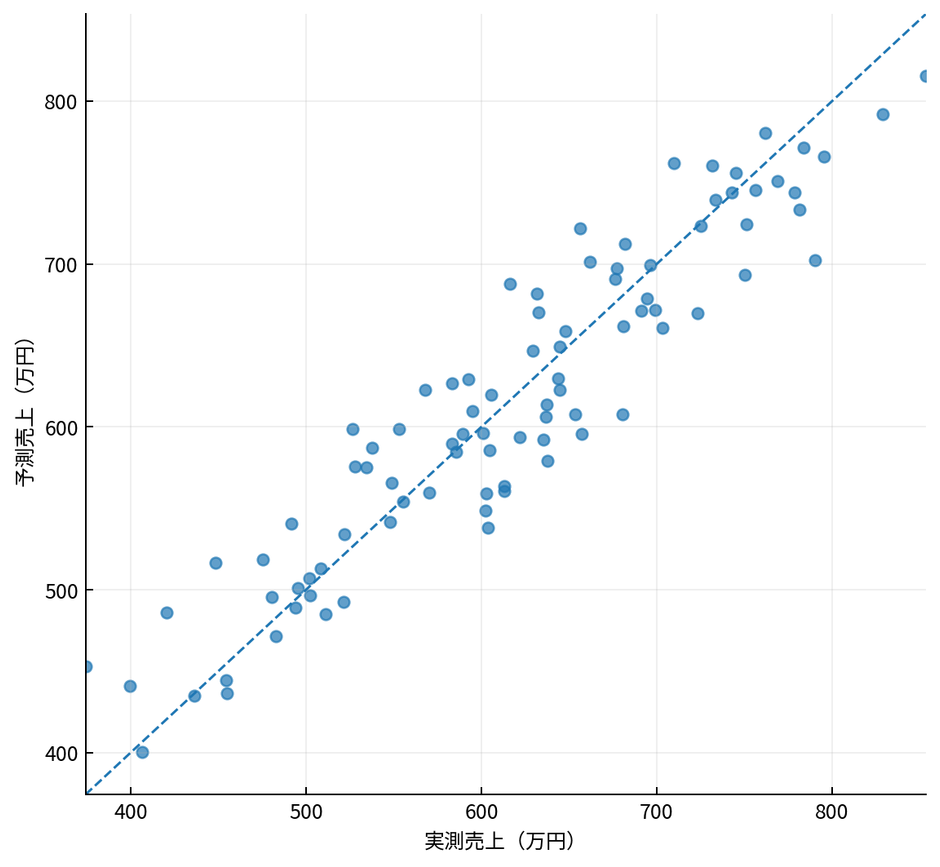
したがって、R²を「正解率」と呼ぶのは適切ではありません。R²が0.8でも「80%の予測が正解した」という意味ではありません。今回のテストデータではR²は0.878でした。
| 指標 | 結果 | 読み方 |
|---|---|---|
| R² | 0.878 | 目的変数の変動に対する線形モデルの説明度を見る |
| MAE | 30.226万円 | 絶対誤差の平均 |
| RMSE | 37.337万円 | 大きな誤差を相対的に強く反映する |
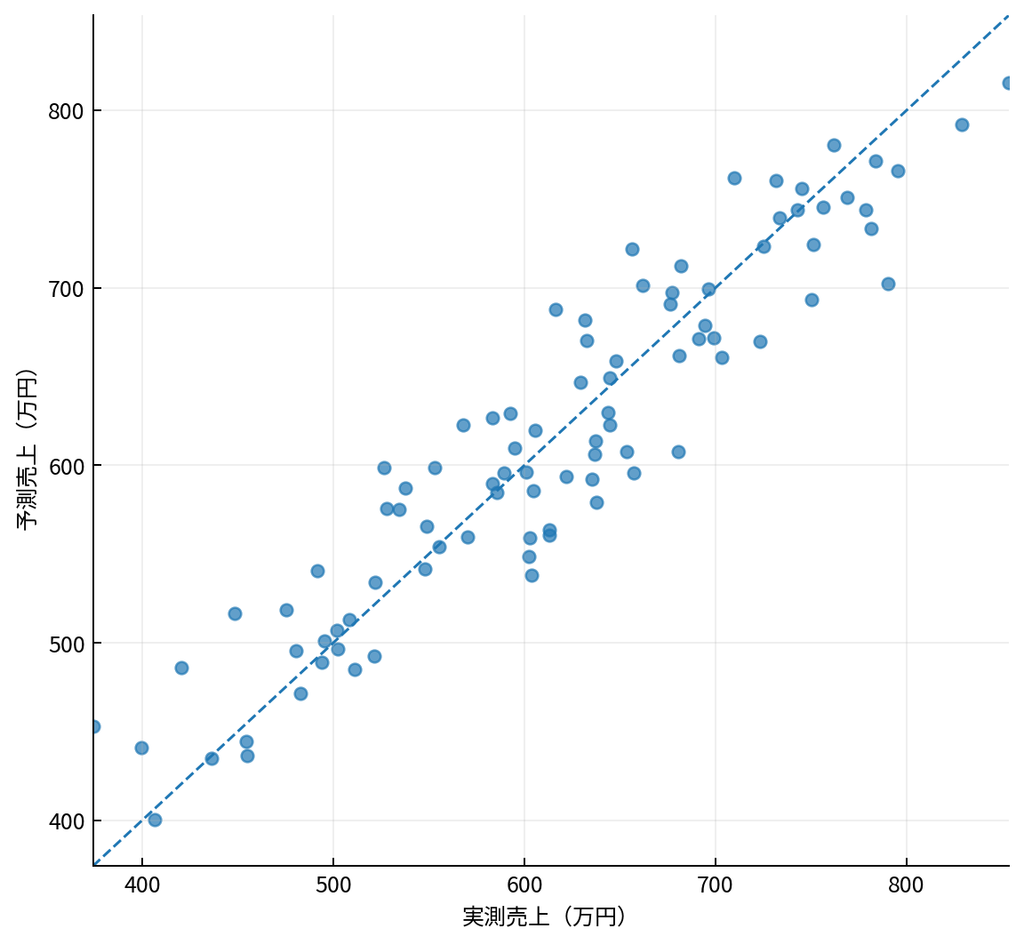
破線に近いほど実測値と予測値が近いことを示します。
R²が高くても、将来時点では取得できない説明変数が入っている、特定条件でだけ大きく外れる、データ期間をまたいだ情報漏洩がある、といった問題があれば実務には使いにくくなります。R²は重要な指標ですが、モデル採用の単独基準ではありません。
学習データとテストデータを分けて評価する理由
回帰モデルを作ったデータそのものだけでR²を確認すると、そのデータへの当てはまりを見ていることになります。実務で知りたいのが「まだ見ていないデータに対してどの程度使えるか」であれば、学習に使わないテストデータを別に用意して評価する必要があります。
今回も360件の人工データを学習用75%、テスト用25%に分けています。係数は学習データだけから推定し、R²・MAE・RMSEは学習に使っていないテストデータで計算しました。この区別をしないと、説明変数を増やした結果として学習データへの当てはまりだけが改善し、未知データではそれほど改善していない状況を見落とす可能性があります。
なお、実際の月次売上や需要など時間順序を持つデータでは、単純なランダム分割よりも「過去で学習し、未来で評価する」分割が適切な場合があります。どの分割方法を使うかは、モデルを本番でどのように利用するかに合わせて決めます。
残差とは何か
R²やMAEは誤差を1つの数値に要約します。一方、残差を見ると「どのように外れているか」を確認できます。今回のモデルでは、各テストデータについて残差 = 実測売上 − 予測売上を計算しています。
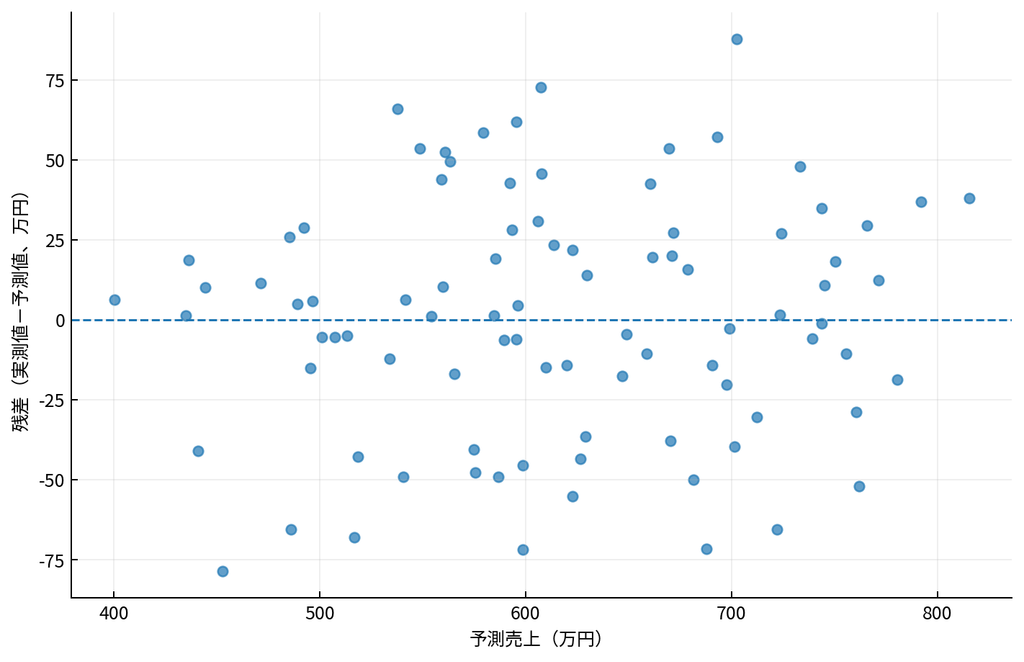
0を中心に大きな規則性なく散らばっていれば、この観点では線形モデルが系統的な構造を強く取り残している兆候は見えにくい状態です。
残差の平均が小さいことだけでは十分ではありません。予測値が大きくなるほど残差の幅も広がる、曲線状のパターンが出る、特定範囲で同じ方向に外れる、といった構造がないかを見ることが重要です(Weisberg, 2005)。
非線形成分を入れると残差はどう変わるか
診断用に、広告費について二次的な非線形成分を追加した別の人工データを作り、あえて通常の線形回帰を当てました。このデータでもR²は0.836ですが、残差には線形データとは異なる構造が現れます。
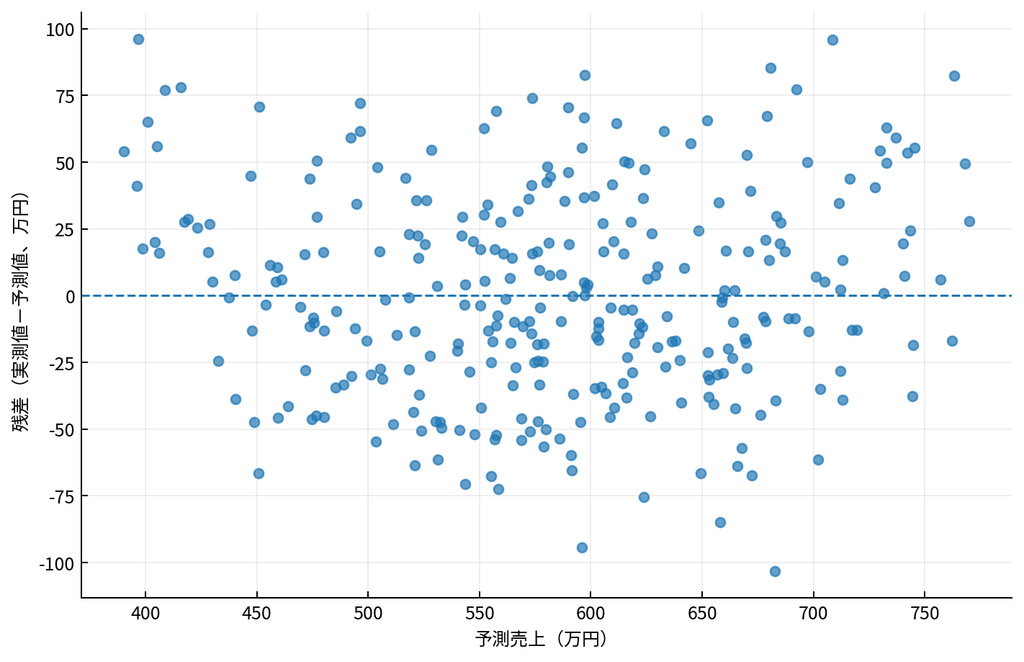
R²だけでなく残差を見ることで、モデルが取り残した構造に気づきやすくなります。
また、OLSでは残差を二乗するため、非常に大きな残差を持つデータは推定結果へ強く影響する可能性があります。売上データなら、大型案件、計上タイミングのずれ、入力ミス、特殊イベントなどが外れ値として見えることがあります。機械的に削除するのではなく、まず業務上の理由を確認します。
線形回帰で注意したい前提と限界
線形関係を仮定している
線形回帰は、説明変数と目的変数の平均的な関係を線形な形で表します。広告費の効果が一定額を超えると頭打ちになるような関係では、そのままの線形式だけでは構造を十分に表せない場合があります。図4のような残差パターンは、その可能性を考える材料になります。
説明変数同士の相関
広告費と営業件数がほぼ同じタイミングで増減するなど、説明変数同士が強く相関していると、個々の係数が不安定になることがあります。係数を解釈したい場合には、目的変数との関係だけでなく説明変数間の関係も確認します。
説明変数が多い場合や係数の安定性が課題になる場合は、正則化を加えた回帰も候補になります。Ridge回帰・Lasso回帰については、SCI-Naviの関連記事で整理しています。
分散が一定でない場合
予測値が大きくなるほど残差のばらつきも大きくなるような場合は、不均一分散が疑われます。線形回帰に関する推測統計では、誤差構造に関する仮定が標準誤差や検定などに影響します。回帰モデルを当てること自体と、係数の信頼区間や検定をどの前提で解釈するかは分けて考える必要があります。
「誤差が正規分布でないと線形回帰できない」は言いすぎ
線形回帰を学ぶと「誤差は正規分布に従う」という説明を見ることがありますが、ここは目的を分けて理解する必要があります。OLSで残差平方和を最小化して係数を求める計算自体は、誤差が完全な正規分布でなければ実行できないわけではありません。
一方、係数のt検定や信頼区間など古典的な推測統計を有限標本で解釈するときには、誤差分布や独立性、等分散性などの仮定が重要になります。つまり「予測用の線形モデルを当てること」と「推測統計として係数の不確実性を評価すること」は同じ論点ではありません。目的に応じて前提を確認する必要があります(Seber and Lee, 2003)。
時系列データの自己相関
月次売上のような時系列では、隣り合う月の誤差が独立でないことがあります。本記事では仕組みを理解するため独立な人工観測としてデータを生成していますが、実際の時系列データでは時間順序を考えた評価や残差の自己相関確認が必要になる場合があります。
回帰係数と因果関係は別
線形回帰は変数間の関係を整理する道具ですが、観測データから得られた係数だけで因果関係を証明することはできません。施策効果を知りたい場合は、交絡、施策選択の偏り、実験設計など別の論点が加わります。
実務で線形回帰を使うときの考え方
説明したいのか予測したいのかを決める
同じ線形回帰でも、「売上と広告費の関係を説明したい」のか、「将来の売上を予測したい」のかで評価方法は変わります。説明が目的なら係数の解釈やモデル仕様が重要になります。予測が目的なら、未知データでの誤差や本番で利用できる特徴量がより重要になります。
同じ数式を使っていても、目的が違えば「良いモデル」の条件も変わります。経営企画やDXの実務では、モデルを選ぶ前に、分析結果をどの判断へ使うのかを決めておくと、必要なデータと評価指標を整理しやすくなります。
R²だけでモデルを採用しない
R²が高くても、予測時点では取得できないデータを使っている、特定セグメントだけ誤差が大きい、係数の解釈が業務知識と矛盾する、といった問題があれば見直しが必要です。R²、MAE、RMSE、残差、データ定義を合わせて確認します。
残差から次の分析を考える
残差に規則性があれば、「線形でない関係があるのではないか」「季節性や顧客規模などの説明変数が抜けているのではないか」という次の仮説につながります。線形回帰は最終回答というより、データ構造を理解し、次の分析を設計する基準モデルとしても使えます。
線形回帰の用途や単回帰・重回帰のビジネス例を先に確認したい場合は、SCI-Naviの「線形回帰とは?単回帰・重回帰で解けるビジネス課題とPython実装例」をご覧ください。本記事は、最小二乗法・係数・R²・残差の仕組みを深掘りする位置づけです。
説明変数が増えた場合や係数の不安定性、正則化まで学びたい場合は「Ridge回帰とLasso回帰とは?正則化の基礎・ビジネス活用例・Python実装を解説」も関連します。
まとめ:係数・R²・残差をセットで読む
- 線形回帰は目的変数を説明変数の線形結合で表す
- OLSは残差平方和を最小にする係数を推定する
coef_は回帰係数、intercept_は切片に対応する- R²は正解率ではなく、目的変数の変動に対するモデルの説明度を見る指標である
- 残差を見ると、R²だけでは分からない外れ方や構造を確認できる
- 係数は因果効果ではなく、単位の異なる係数を大きさだけで比較しない
- 実務では分析目的、データ定義、評価条件、業務知識を合わせて判断する
Pythonで線形回帰を実装すること自体は難しくありません。実務では、その前後にある「何を目的変数とするか」「どの説明変数を使うか」「その係数をどこまで意味づけできるか」「分析結果をどの意思決定へ使うか」の設計が重要です。
SCI総合研究所株式会社のRASHINRAでは、売上・営業・マーケティング・業務データなどを対象に、分析テーマの整理、データ設計、回帰分析を含む手法選択、結果の解釈、意思決定への活用までを支援しています。係数やR²を算出するだけでなく、自社データからどの判断材料を作るべきか整理したい場合はご相談ください。
参考文献
- Seber, G. A. F. and Lee, A. J. 2003. Linear Regression Analysis. John Wiley & Sons. 2nd Edition. https://doi.org/10.1002/9780471722199
- Weisberg, S. 2005. Applied Linear Regression. John Wiley & Sons. 3rd Edition. https://doi.org/10.1002/0471704091
- Pedregosa et al. 2011. Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research. Vol. 12. pp. 2825-2830. https://www.jmlr.org/papers/v12/pedregosa11a.html