
店舗を比較するとき、来店頻度が高い店舗、客単価が高い店舗というように、いくつかのタイプへ分けて考えることがあります。しかし、実際の店舗群が明確な境界で分かれているとは限りません。今回は、高頻度・低単価から低頻度・高単価へ店舗が連続的につながる構造を、二変量density fieldとridgeを使って可視化しました。
この図は何を表しているのか
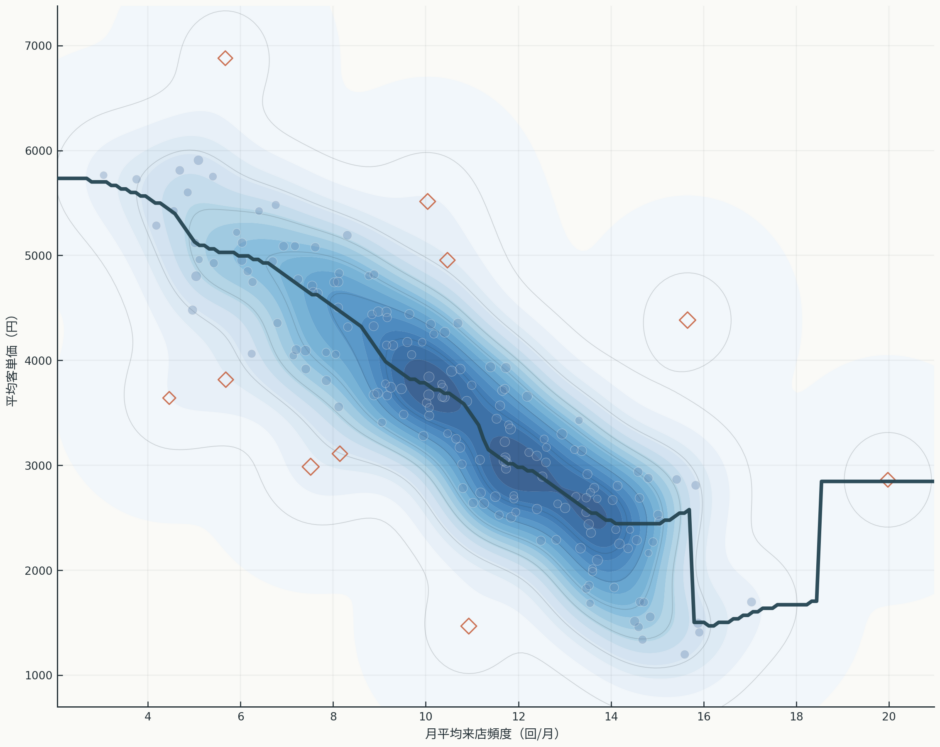
横方向は月平均来店頻度、縦方向は平均客単価です。各点は1店舗を表しています。
背景の濃淡は、その周辺にどれだけ多くの店舗が存在するかを示す二変量密度です。濃い領域ほど、似た来店頻度と客単価を持つ店舗が多く存在します。
濃いridge lineは、来店頻度ごとに最も店舗密度が高い客単価を結んだ経路です。このridgeを見ることで、店舗分布の中心が高頻度・低単価から低頻度・高単価へどのように移動しているかを確認できます。
可視化から読み取れること
今回のSynthetic Dataでは、来店頻度と客単価のPearson相関は-0.84でした。全体として、来店頻度が高いほど客単価が低く、来店頻度が低いほど客単価が高い方向の関係を持っています。
latent position下位20%の店舗では、平均来店頻度は14.6回/月、平均客単価は2112円でした。一方、latent position上位20%では、平均来店頻度は6.3回/月、平均客単価は5105円でした。
ただし、分布は二つの孤立した塊ではなく、その間を店舗点とdensity ridgeが連続的につないでいます。また、Ground Truthとして10店舗の構造的な例外も追加しており、ridgeから外れる店舗として図中に現れます。
この構造をどう解釈するか
今回のデータでは、店舗ごとに0から1までのlatent positionを設定しています。latent positionが小さいほど高頻度・低単価、大きいほど低頻度・高単価になるように来店頻度と客単価を生成しました。
そのため、ridgeは「二つのクラスタの境界」ではなく、latent continuumが観測空間に現れた中心経路と解釈できます。
一方で、diamond outlineで示した例外店舗は、同じlatent structureだけでは説明しにくい位置へ意図的に配置しています。実データで同様の店舗が見つかった場合は、その背景に異なる商圏、業態、販促、店舗規模などがあるかを追加分析するきっかけになります。
可視化の仕組み
まず、各店舗の来店頻度と客単価を二次元平面上へ配置します。その後、各店舗点を中心にGaussian kernelを置き、それらを重ねて連続的なdensity fieldを作ります。
次に、来店頻度の各位置について、最も密度が高い客単価を抽出し、その点をつないでridgeとします。
これにより、個々の店舗点だけを見るよりも、店舗群全体がどの方向へ集中し、その中心構造がどのように変化するかを把握しやすくなります。
なぜこの可視化方法を選んだのか
今回の目的は、店舗をいくつかの固定カテゴリへ分類することではなく、高頻度・低単価から低頻度・高単価へ連続的に変化する構造を見ることです。
通常のscatter plotでも2変数の関係は確認できますが、店舗数が増えると点の重なりが起き、分布の中心がどこにあるかが読みづらくなります。
Bivariate density ridge fieldでは、個々の店舗点を残しながら、distribution全体の中心経路をridgeとして抽出できます。そのため、「群」よりも「連続体」を主題にする今回のVisualizationに適しています。
実データへの応用可能性
実データでは、店舗別の顧客ID付き購買履歴や会員データから、一定期間の来店頻度と客単価を計算することで同様の構造を探索できます。
たとえば、店舗フォーマット、商圏、立地、顧客層などによって、ridge上のどの位置に店舗が現れるかを比較できます。また、ridgeから大きく外れる店舗を抽出し、その理由を追加分析する用途も考えられます。
ただし、来店頻度と客単価の位置だけから店舗の優劣や施策効果を判断することはできません。
データと分析方法
今回はSynthetic Dataを使用しています。店舗数は180です。乱数シードは260926です。
各店舗にはlatent positionを設定し、その値に応じて来店頻度を減少、客単価を上昇させました。その後、両変数へ観測ノイズを加え、さらに10店舗を構造的な例外として追加しています。
密度推定にはGaussian kernel fieldを用い、来店頻度方向のbandwidthを0.75回/月、客単価方向を360円としました。ridgeは各来店頻度位置でdensityが最大となる客単価として抽出しています。
このVisualization Studyの限界
今回の連続構造はSynthetic DataのData Generating Processとして設計されています。実データで同じ単一のlatent continuumが存在するとは限りません。
また、density fieldとridgeの形状はbandwidthに依存します。bandwidthが小さすぎると局所的な凹凸が増え、大きすぎると実際の構造を平滑化しすぎる可能性があります。
さらに、来店頻度と客単価だけでは店舗特性を十分に説明できません。売場面積、立地、商圏、商品構成、顧客属性などを追加すると、異なる構造が現れる可能性があります。
まとめ
今回は、店舗別の来店頻度と客単価を二変量density fieldとして可視化し、その中心経路をridgeとして抽出しました。
Synthetic Dataでは、高頻度・低単価から低頻度・高単価へ店舗群が連続的につながる構造を設定しており、その関係が密度の尾根として現れました。
この見方は、店舗を固定的な二群へ分ける前に、分布全体がどのような連続構造を持っているかを探索する方法として利用できます。