
サプライチェーンのリスクを考えるとき、直接取引しているサプライヤーの状況は比較的把握しやすい一方、そのさらに上流にある企業との依存関係は見えにくくなります。今回は、Tier 3の一社で発生した問題が取引関係を通じてTier 2、Tier 1、最終企業へどのように伝播するかを、multi-tier networkとして可視化しました。
この図は何を表しているのか
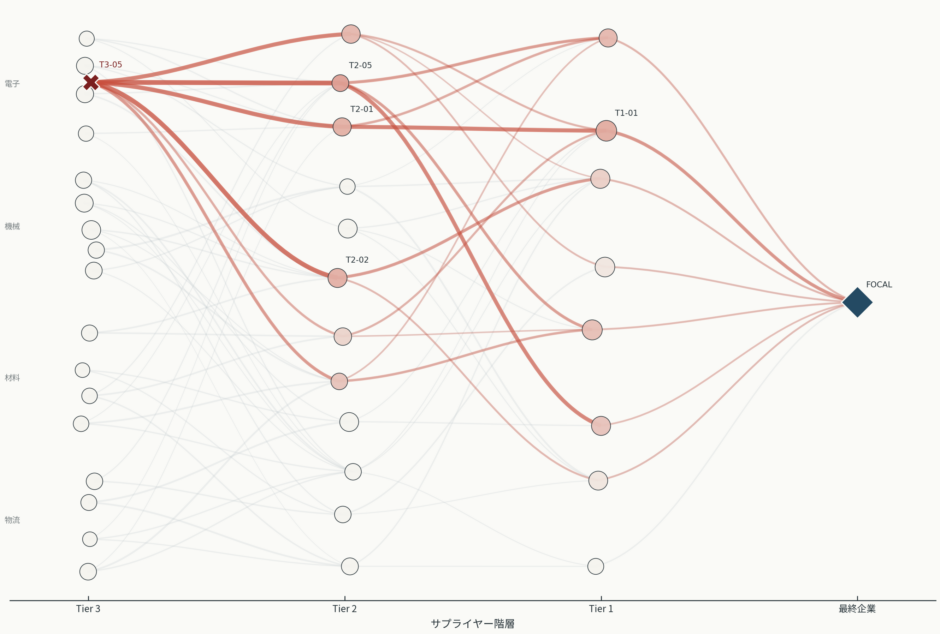
図は左から右へTier 3、Tier 2、Tier 1、最終企業の順に並んでいます。nodeは企業、edgeは取引関係を表します。
薄い灰色のedgeはSynthetic supply network全体の取引関係です。その上に重なる赤いedgeは、Tier 3のincident sourceからMonte Carlo simulation上で実際にriskが流れた経路です。太く濃いほどrisk flowが大きい関係です。
node sizeはcriticality、nodeの色の強さはdisruption probabilityを表します。問題発生元はX marker、最終企業はdiamond markerで区別しています。
可視化から読み取れること
今回のSynthetic Dataでは、39 nodeと86 directed edgeからなる4層networkを使用しました。
incident source以外でdisruption probabilityが10%以上となったnodeは12あり、そのうち6 nodeはsourceから直接接続されていないindirect dependencyでした。
さらに、sourceから2 hop以上離れていてrisk probabilityが20%以上となったnodeは6ありました。
最終企業FOCALのdisruption probabilityは49.0%でした。sourceとFOCALの間には直接取引edgeがないため、この値はmulti-tier pathを通じた伝播として生じています。
この構造をどう解釈するか
今回のData Generating Processでは、各取引edgeにdependencyとpropagation probabilityを設定しています。dependencyが高く、取引先側のbufferが小さいほど、上流supplierのdisruptionが次のtierへ伝わりやすい設計です。
source incidentはTier 3の一社で固定し、その後の伝播だけを確率的にsimulationしています。したがって、図中の赤いflowは単なる強調線ではなく、設定したGround TruthとMonte Carlo simulationから得られたrisk propagationを反映しています。
複数の上流pathが同じnodeへ合流する場合、一つのdirect supplierだけを見たときよりもrisk probabilityが高くなることがあります。今回のVisualizationでは、こうしたmulti-path dependencyをnetwork structureとして捉えています。
可視化の仕組み
まずTier 3、Tier 2、Tier 1、最終企業からなるdirected acyclic networkを生成します。各supplierにはcriticalityとbufferを持たせ、取引edgeにはdependencyを設定します。
edgeごとのpropagation probabilityはdependencyとtarget bufferから計算します。その後、Tier 3のsourceを必ずdisruptedな状態として、30,000回のindependent-cascade simulationを実行しました。
各nodeが何回disruptedになったかをsimulation回数で割ることでnode risk probabilityを求めます。同様に、各edgeが何回riskを伝えたかからedge trigger probabilityを推定しています。
なぜこの可視化方法を選んだのか
今回のテーマでは、リスクの大きさだけでなく「どの経路を通って伝わったか」が重要です。
表形式やsupplierごとのrisk scoreでも個別企業のリスクは確認できますが、multi-tier dependencyや複数pathの合流を一つの構造として読むにはnetwork representationが適しています。
Multi-tier risk propagation networkでは、supplier tierと取引関係を保持したまま、source incidentからのrisk flowを上に重ねられます。そのため、直接取引先だけでは見えない依存を視覚的に探索できます。
実データへの応用可能性
実データでは、supplier master、調達品目、取引依存度、代替可能性、在庫bufferなどを組み合わせることで、同様のmulti-tier dependencyを探索できる可能性があります。
たとえば、直接取引先ではない上流supplierへの依存、複数のTier 1 supplierが共通して依存するTier 2 / Tier 3企業、単一sourceから多くのpathが集中するnodeなどを探索する用途が考えられます。
ただし、実際のdisruption probabilityを推定するには、取引量、代替調達、在庫、復旧時間など追加情報が必要です。
データと分析方法
今回はSynthetic Dataを使用しています。node数は39、directed edge数は86、Monte Carlo simulationは30,000回です。乱数シードは260926です。
各nodeにはtier、domain、criticality、bufferを設定し、edgeにはdependencyとpropagation probabilityを持たせています。Tier 3のT3-05をincident sourceとし、Independent Cascade型のsimulationで各nodeのdisruption probabilityを推定しました。
sourceから直接出るedgeについて、設定したpropagation probabilityとsimulationで観測されたtrigger probabilityの平均絶対誤差は0.003でした。
このVisualization Studyの限界
今回のnetworkとpropagation probabilityはSynthetic Dataとして設計されています。実際のサプライチェーンで同じ構造や同じ確率が成立することを示すものではありません。
また、今回のsimulationではriskは上流から下流へ一方向に伝播し、復旧時間や時間遅れ、代替調達、複数incidentの同時発生は扱っていません。
edge間の伝播も条件付き独立として扱っています。現実には地域災害や共通インフラなどにより複数supplierのfailureが相関する可能性があります。
そのため、このStudyは実際の損失確率を算定するモデルではなく、multi-tier dependencyをどう可視化できるかを検討するVisualization Studyです。
まとめ
今回は、Tier 3の一社で発生した問題が取引関係を通じて複数tierへ伝播する構造を、Multi-tier risk propagation networkとして可視化しました。
direct relationshipだけを見る場合には現れないTier 1や最終企業へのriskが、複数stageのedge flowとして見える構成になっています。
この見方は、実データでも直接取引先だけでは捉えにくいupstream dependencyを探索し、追加調査すべきsupplierやpathについて仮説を作るための入口として利用できます。

