
調達リードタイムを比較するとき、まず平均日数を見ることが多いと思います。しかし、平均が同じでも、毎回ほぼ同じ日数で届くサプライヤーと、遅延が連続したり、大きなショックの後に長く回復しなかったりするサプライヤーでは、調達上の不確実性は異なります。今回は、その違いを将来trajectoryの「扇」として可視化しました。
この図は何を表しているのか
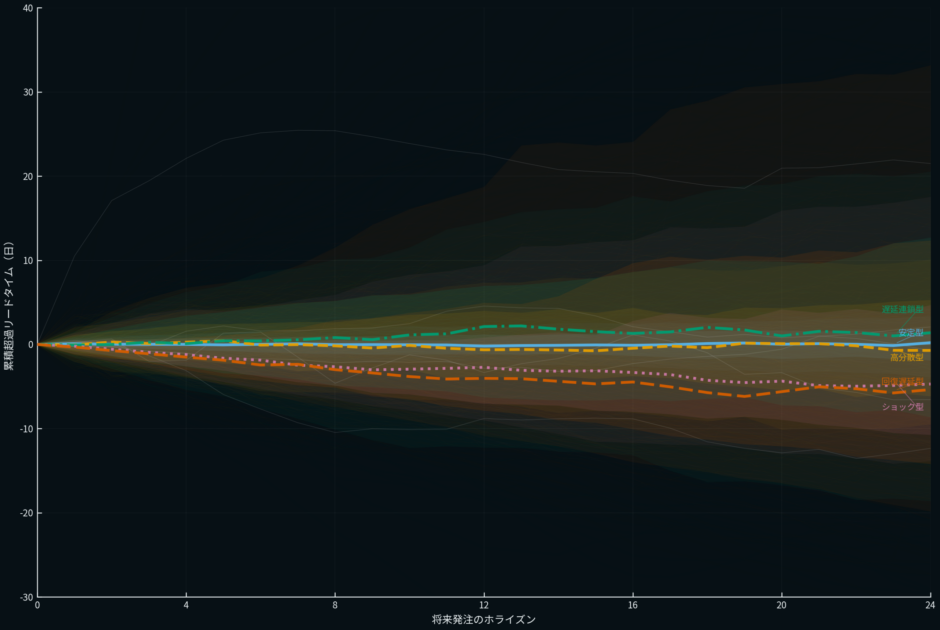
横方向は、これから何回先の発注まで見るかというfuture order horizonです。縦方向は、平均リードタイム12日を基準にした累積超過lead timeです。
たとえば、ある発注で平均より2日遅く、次の発注でさらに1日遅ければ、累積値は3日になります。逆に平均より短いlead timeが続けば、trajectoryは下方向へ進みます。
非常に細い線は個々のfuture scenarioです。半透明の外側の帯は10–90%、内側の帯は25–75%の範囲、太い線はmedian trajectoryを表します。fanが広いほど、将来の累積遅延に大きな不確実性があります。
可視化から読み取れること
今回のSynthetic Dataでは、25サプライヤーすべての平均lead timeを12日に揃えています。Supplier平均値の最大差は0.0000日でした。
一方、lead timeの標準偏差はStableで平均0.51日、Volatileで1.55日となり、平均値では見えない変動幅の差が現れました。
lag-1 autocorrelationはStableで0.12、Persistentでは0.77でした。Persistentでは、ある発注で生じた偏りが次の発注にも残りやすい構造です。
24発注先での10–90% cumulative-delay幅は、Stableが6.5日、Volatileが20.2日、Shock-sensitiveが33.0日、Recovery-laggedが50.2日でした。
この構造をどう解釈するか
今回のData Generating Processでは、すべてのsupplier typeで長期平均lead timeを12日に揃えています。そのうえで、変動の大きさ、自己相関、delay shockの発生頻度、shock magnitude、shockの減衰速度だけを変えました。
Stableはvarianceが小さく、前回の遅れも残りにくいためfanが狭くなります。Volatileは一回ごとのvariationが大きいため、正負の両方向へ広く開きます。
PersistentではAR persistenceを高くしているため、一方向の偏りが数回続きやすくなります。Shock-sensitiveでは頻度は低くても大きな正のdelay shockが入り、一部trajectoryが上方向へ大きく伸びます。
Recovery-laggedではshock decayを遅く設定しているため、一度の遅延の影響が次の発注にも残りやすい構造になります。
可視化の仕組み
各supplierのlead time deviationは、AR型の連続的な揺らぎとdelay shock stateを組み合わせて生成しました。
AR componentは前回の偏りが次回へどれくらい残るかを表します。shock stateは、大きな遅延が発生した後、その影響が何回かの発注に残る構造です。
shockは正の遅延として発生しますが、長期平均がtypeごとに変わらないようstationary meanを差し引いています。さらに観測系列をsupplierごとに12日へ再中心化し、平均値ではなくvariation structureを比較する設計にしました。
その後、各supplierについて24発注分のfuture scenarioを36本ずつ生成し、平均12日からの偏差を累積してtrajectoryを作っています。
なぜこの可視化方法を選んだのか
平均値と標準偏差だけでもsupplierごとの違いは数値として比較できます。しかし、今回見たいのは「遅れがどのように積み重なるか」です。
Lead-time uncertainty trajectory fanでは、将来scenarioを一つの原点から重ねることで、varianceの違いだけでなく、一方向へのpersistence、大きなshock、shock後のslow recoveryをtrajectory geometryとして読むことができます。
そのため、平均lead timeが同じでも調達上の揺らぎ方が異なるという今回のテーマに適しています。
実データへの応用可能性
実データでは、発注日、入荷日、supplier ID、品目、予定lead timeなどからsupplierごとのlead-time sequenceを作ることで、同様の構造を探索できる可能性があります。
平均lead timeが近いsupplier同士でも、variance、serial dependence、delay run、shock recoveryが異なるかを調べることで、平均値だけでは捉えにくい調達不確実性について仮説を作ることができます。
ただし、実際のsupplier評価には、品目差、輸送経路、季節性、発注量、在庫buffer、代替調達可能性なども併せて確認する必要があります。
データと分析方法
今回はSynthetic Dataを使用しています。supplier数は25、各supplierの観測期間は104、観測数は2600です。乱数シードは260926です。
lead timeのtarget meanは12日です。Supplier typeごとにinnovation variance、AR persistence、shock probability、shock magnitude、shock decayを設定しました。
可視化では各supplierについて24発注分のscenarioを36本生成し、その累積lead-time deviationから10–90%、25–75%、median trajectoryを計算しています。
このVisualization Studyの限界
今回のsupplier typeとdelay processはSynthetic Dataとして設計したものです。実際の調達lead timeが同じAR + shock structureに従うことを示すものではありません。
また、supplierごとの平均lead timeを意図的に12日へ揃えているため、現実に存在する平均値そのものの差は今回のStudyでは扱っていません。
scenario generationもsupplierごとに独立しており、港湾混雑、自然災害、共通物流網など複数supplierへ同時に影響するcommon shockは含んでいません。
さらに、trajectory fanの広がりは設定したhorizonとDGP parameterに依存します。そのため、実データではmodel selectionやparameter uncertaintyも確認する必要があります。
まとめ
今回は、平均lead timeを同じ12日に揃えたsupplierについて、variation、persistence、shock、recoveryの違いをLead-time uncertainty trajectory fanとして可視化しました。
平均値が同じでも、将来trajectoryのfan widthや形は大きく異なります。調達lead timeを一つの代表値だけで見るのではなく、時間的な揺らぎ方として捉えることで、別のrisk structureを探索できます。
この見方は、実データでも平均lead timeだけでは区別しにくいsupplier uncertaintyを比較し、追加調査すべき変動パターンについて仮説を作るための入口として利用できます。