
企業を分類するとき、業種は分かりやすい基準です。しかし、供給関係の観点から見ると、異なる業種の企業が同じ部品や技術へ依存し、同じ供給コミュニティを形成することがあります。今回は、部品依存と技術依存を別々のnetwork layerとして持つSynthetic Dataを生成し、業種分類とは異なる供給上のまとまりをMultiplex supplier community mapとして可視化しました。
この図は何を表しているのか
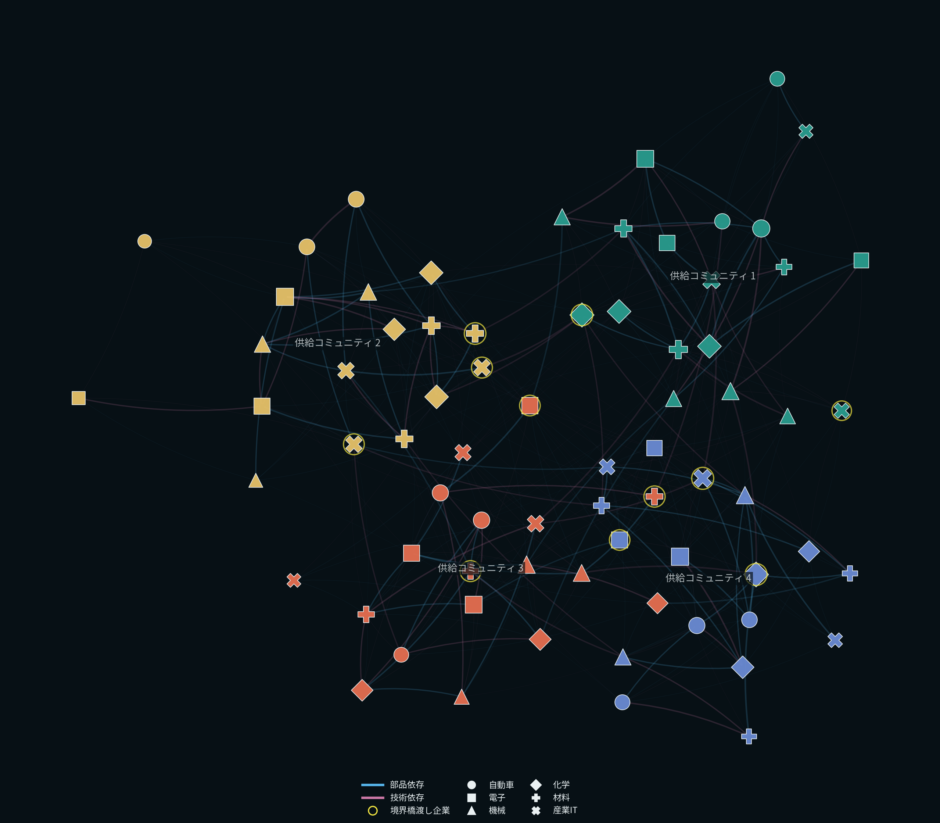
図中のnodeは企業です。nodeの位置は、部品依存と技術依存を統合したmultiplex networkに対するforce-directed layoutによって決まります。関係の強い企業ほど近くに配置されやすくなります。
nodeの色はLouvain法で検出された供給コミュニティ、marker shapeは業種です。つまり、同じ色のcluster内に異なるshapeが混在していれば、異業種企業が同じ供給communityへ属していることを示します。
青系のcurved edgeは部品依存、magentaのcurved edgeは技術依存です。二つのlayerではcurveの向きを反転しているため、同じ企業pairが両方の関係を持つ場合も重なりを追えます。
黄色いouter ringは、複数communityへ関係が分散しているhigh-participation firmです。これらはcommunity同士の境界を橋渡しする位置にあります。
可視化から読み取れること
今回のSynthetic Dataには72企業があります。部品依存edgeは196本、技術依存edgeは154本で、統合後のmultiplex edgeは318本でした。
Community detectionでは4個のcommunityが検出されました。Ground Truthとして埋め込んだlatent communityとのAdjusted Rand Indexは0.96でした。一方、業種分類とのAdjusted Rand Indexは-0.05でした。
Latent-community partitionのmodularityは0.49、industry partitionでは-0.04でした。
また、検出community内部にあるedgeのうち87.5%は異なる業種間を結ぶedgeでした。Network weight全体でもcross-industry tieが86.8%を占めています。
この構造をどう解釈するか
今回のData Generating Processでは、業種と供給communityを別のlatent variableとして設計しています。
各latent communityには6業種から3社ずつ配置し、合計18社を所属させました。したがってcommunity内部は最初から業種横断的です。
そのうえでPart layerとTechnology layerの両方について、同じlatent community内部ではedgeが生じやすく、community間ではedgeが少なくなるようprobabilityを設定しました。ただしedge realizationはlayerごとに異なるため、部品依存と技術依存は同一networkではありません。
この共通構造とlayer固有の関係を統合することで、aggregate multiplex networkからlatent supply communityが回収されるよう設計しています。
可視化の仕組み
まず72企業をAutomotive、Electronics、Machinery、Chemicals、Materials、Industrial ITの6業種へ12社ずつ割り当てました。
同時に、業種とは独立した4つのlatent supply communityへ18社ずつ配置しています。それぞれのcommunityには全6業種が含まれます。
Part dependencyとTechnology dependencyについて別々のedge setとweightを生成しました。layer間でweight scaleが異なるため、それぞれの平均edge weightで正規化してから合算しています。
そのaggregate multiplex networkへLouvain community detectionを適用し、同じnetwork weightを使ったforce-directed layoutを計算しました。
なぜこの可視化方法を選んだのか
今回見たいのは、一つの企業が複数種類の依存関係を持ちながら、どの供給communityへ組み込まれているかという構造です。
Multiplex supplier community mapでは、nodeを一つの空間に固定したまま、部品依存と技術依存を別edge layerとして重ねられます。そのため、community構造とlayerの違いを同じcompositionの中で比較できます。
さらにmarker shapeを業種へ割り当てることで、network clusterと既存の業種分類が一致しているのか、それとも異業種が混在しているのかを同時に確認できます。
実データへの応用可能性
実データでは、企業間取引、部品共通性、技術ライセンス、特許引用、共同開発、共通vendorなど複数種類のrelationがあれば、同様のmulti-layer structureを探索できる可能性があります。
たとえば、業種分類上は離れている企業でも、同じ部品メーカーや技術platformへ依存していることで同じ供給communityに属する可能性を調べられます。
このような分析は、既存の業種分類だけでは見えにくいdependency clusterを探索し、追加確認すべき企業群について仮説を作る用途に利用できます。
データと分析方法
今回はSynthetic Dataを使用しています。企業数は72、部品依存edgeは196、技術依存edgeは154、統合network edgeは318です。乱数シードは260926です。
Part / Technology layerを別々に生成し、layerごとの平均weightで正規化してからaggregate networkを構築しました。Community detectionにはLouvain法を使用し、Ground Truthとの一致度はAdjusted Rand Indexで評価しました。
また、community内部のcross-industry edge share、partition modularity、participation coefficientを補助指標として計算しています。
このVisualization Studyの限界
今回のnetworkはSynthetic Dataであり、現実の企業間取引構造を表しているわけではありません。
Part / Technology edgeは確率的に生成しており、dependency weightもSynthetic parameterです。現実では部品依存と技術依存の測定尺度が異なり、単純なweight normalizationだけで統合できない可能性があります。
Louvain法のcommunity partitionはresolutionやnetwork constructionに依存します。またforce-directed layoutの距離は物理的距離やdependency strengthそのものではなく、network構造を視覚化するための配置です。
したがって、このStudyは実際の企業communityを特定するものではなく、複数layerのdependencyから業種横断的なcommunityをどのように探索・可視化できるかを検討したものです。
まとめ
今回は、部品依存と技術依存を持つ企業networkをMultiplex supplier community mapとして可視化しました。
Synthetic Dataでは、検出communityがGround Truthとして埋め込んだ供給communityと強く対応する一方、業種分類とは対応が弱く、community内部には多くのcross-industry edgeが含まれました。
この見方は、企業を既存の業種区分だけで捉えるのではなく、複数種類の供給・技術依存から別のcommunity structureを探索するための一つの方法になります。