
出荷遅延は、あるshipmentの完了時刻が遅れるだけでは終わらないことがあります。同じ設備を使う後続案件が待たされ、さらに定時出発の輸送枠を逃すことで、下流の遅延が別の時間単位へ拡大することがあります。今回は、一つの上流遅延が後続工程・輸送・納入へどのように波及するかを、時間方向を持つDAGとして可視化しました。
この図は何を表しているのか
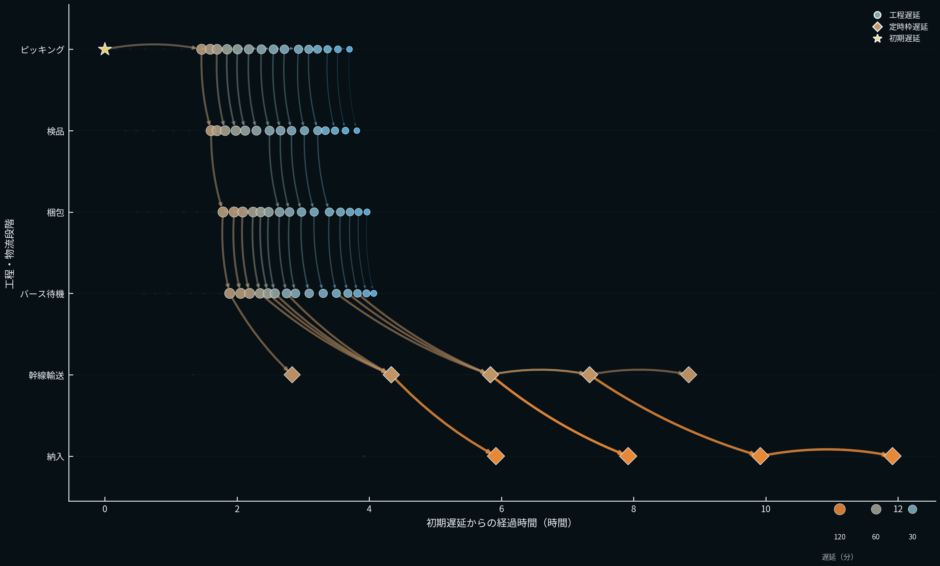
横方向は、初期遅延が発生してからの経過時間です。縦方向にはPicking、Inspection、Packing、Dock staging、Linehaul、Deliveryの6段階を配置しています。
星形のnodeが唯一の外生shockです。丸いnodeは工程内の遅延、菱形nodeは定時出発枠を持つLinehaulまたはDeliveryで発生した遅延です。
nodeが大きいほどdelay minutesが大きく、edgeも大きな遅延を伝えるほど太くなります。色は小さい遅延をcool、大きい遅延をwarmへ連続的に変化させています。
edgeは単なる相関ではなく、今回のSynthetic processにおけるoperational precedenceを表します。同じshipmentの後続工程、同じresourceのqueue、輸送slot capacityによるspilloverを親子関係として接続しています。
可視化から読み取れること
今回のSynthetic Dataでは72件のshipmentを流し、S19のPickingにのみ78分の追加処理を入れました。
Baselineとの差が1分を超えたdelay eventは80件で、20件のshipmentが影響を受けました。
DAG上では、そのうち80件がROOTから到達可能でした。Maximum cascade depthは20で、初期遅延から最後のaffected eventまで11.9時間かかりました。影響が最後まで残ったshipmentはS47でした。
最大遅延は120分で、初期shockの78分に対して1.54倍です。
この構造をどう解釈するか
今回のData Generating Processでは、外生的に変えたのはS19 / Pickingの処理時間だけです。BaselineとShock runでは、それ以外のservice time realization、shipment release、transport scheduleを共通にしています。
Pickingで処理時間が延びると、そのresourceを待つ後続shipmentへqueueが生じます。さらに、そのshipment自身もInspection、Packing、Dock stagingへ遅れて到着するため、遅延は同じshipmentの下流方向にも進みます。
Linehaulは90分ごとのdeparture、Deliveryは120分ごとのwaveとして設計しています。そのため、数十分の遅延であってもdeparture cutoffを越えると、次のslotまで待つ必要があります。
今回、Linehaulでは11件に影響が残り、最大90分、Deliveryでは9件に最大120分の遅延が生じました。連続的な工程遅延がscheduled transportを通ることで、離散的なdelay plateauへ変換されています。
可視化の仕組み
まず72件のshipmentを15分間隔でreleaseします。Picking、Inspection、Packing、Dock stagingはsingle-resource queueとして処理します。
次にLinehaulを90分間隔・1便7件、Deliveryを120分間隔・1便10件のscheduled waveとして設定しました。
同じservice timeを用いたBaseline runとShock runを実行し、各stageのcompletion time差を計算します。1分を超える差だけをdelay eventとして抽出しました。
DAG edgeは、各eventがどのoperational constraintによって遅れたかをもとに構成しています。resource queueの場合は直前job、同一shipmentの後続stageではprecedence、輸送capacity spilloverでは前のslotに関係するeventをparent候補としています。
なぜこの可視化方法を選んだのか
遅延量をstage別に集計するだけでも、どの工程で遅れが大きいかは確認できます。しかし今回の主題は「一つの遅延が時間差でどこへ連鎖したか」です。
Delay cascade temporal DAGでは、時間を横軸、工程を縦軸へ固定しながら、event間の因果的precedenceをedgeで残せます。そのため、同じstage内のqueue propagationと、shipment内部のdownstream propagationを同じ図で追えます。
また、scheduled transportでdelayが急に大きくなる位置も、node sizeとedge widthの変化として確認できます。
実データへの応用可能性
実データでは、order / shipment ID、工程開始・完了時刻、輸送便、納入時刻、resource IDなどがあれば、同様のdelay propagation structureを探索できる可能性があります。
たとえば、ある工程の遅延後にどのshipmentへqueueが広がったか、どのtransport cutoffで遅延が大きくなったか、どのstageで回復したかを探索できます。
ただし、実データから因果edgeを構築するには、単なる時刻順だけではなく、resource occupancyやprecedence relationなどのprocess情報が必要です。
データと分析方法
今回はSynthetic Dataを使用しています。shipment数は72、stage数は6、乱数シードは260926です。
Picking〜Dock stagingにはservice-time variationを持たせていますが、BaselineとShock runで同じrealizationを使っています。唯一の追加shockはS19 / Pickingの+78分です。
delayはShock runのcompletion timeからBaseline runのcompletion timeを引いて算出しました。1分以下の差は可視化対象から除外しています。
このVisualization Studyの限界
今回のprocessはSynthetic Dataであり、実際の物流工程を再現したものではありません。
Picking〜Dock stagingはsingle-resource、LinehaulとDeliveryは固定interval・固定capacityとして単純化しています。実際には複数resource、優先順位変更、express handling、別routeへの振替などによりcascade structureは変わります。
また、DAG edgeは今回のsimulation ruleからoperational parentを割り当てています。実データで同じedgeを得るには、より詳細なevent logとprocess knowledgeが必要です。
したがって、今回の最大120分や11.9時間という数値を現実の物流へ一般化することはできません。確認しているのは、一つの外生delayがqueueとscheduled slotを通じて時間差で連鎖・増幅する構造です。
まとめ
今回は、一つのPicking delayが後続shipment、工程、Linehaul、Deliveryへ伝わる構造をDelay cascade temporal DAGとして可視化しました。
Synthetic Dataでは、78分の初期shockから20件のshipmentへ影響が広がり、scheduled transportを通過した一部eventでは最大120分まで遅延が増えました。
この見方は、遅延を単一shipmentの結果として見るだけでなく、どのoperational relationを通って下流へ伝わったかを時間構造として探索するための一つの方法になります。