
段取り替えを評価するとき、工程全体の平均段取り時間や、品種ごとの平均時間だけを見ることがあります。しかし実際の段取りには方向があります。ある品種から別の品種へ切り替える際、工具・材料・洗浄・温度条件などが同時に変われば、逆方向とは異なる損失構造を持つ可能性があります。今回は、前後品種の組み合わせをmatrixとnetworkで同時に可視化しました。
この図は何を表しているのか
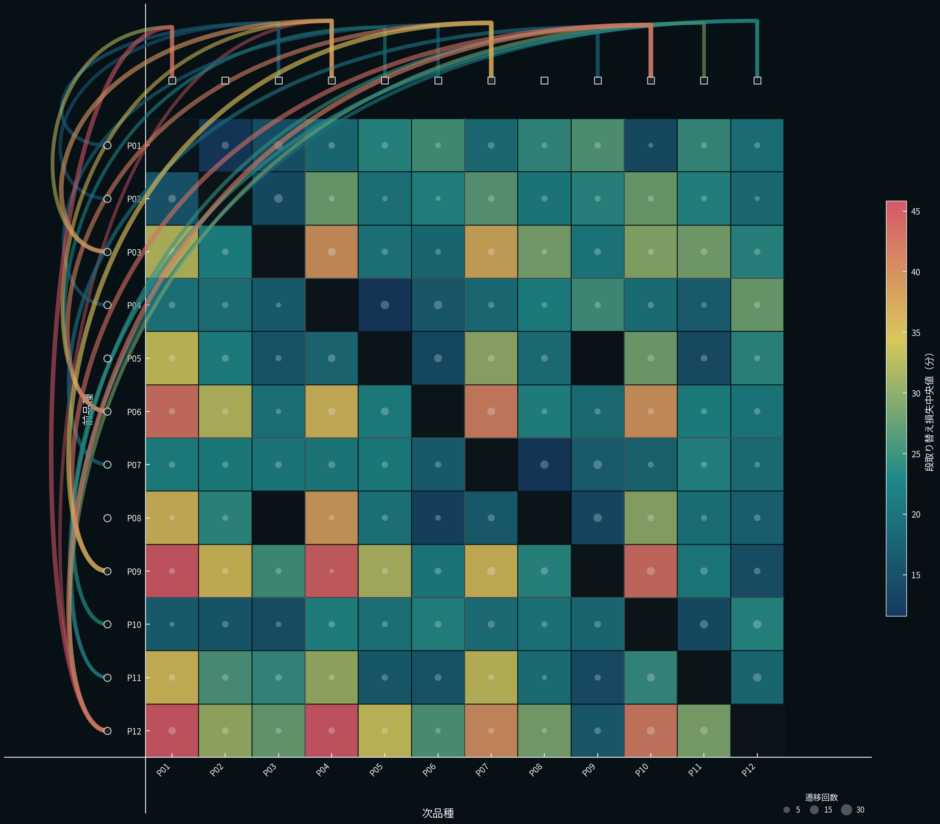
中央のmatrixでは、縦方向が前品種、横方向が次品種です。一つのcellが一つのdirected changeover pairを表します。
Cell colorは、そのpairで観測されたtotal changeover lossの中央値です。ここでのtotal lossはsetup downtimeと、段取り直後のstartup stabilization lossを等価時間に換算した値の合計です。
Cell中央の小さな点はtransition countを表し、繰り返し回数が多いpairほど大きくなります。
Matrixの外側にはcumulative lossの大きい18 pairだけをnetwork edgeとして取り出しています。左側のcircleが前品種、上側のsquareが次品種です。Edge colorはmatrixと同じpair median loss、edge widthはそのpairがproduction sequence全体で積み上げたcumulative lossを表します。
可視化から読み取れること
今回のSynthetic Dataでは12品種、1,200 production runsから1,199回のchangeoverを生成しました。観測されたdirected pairは130種類です。
全changeoverのmedian total lossは22.10分でした。同一family内のtransitionではmedian 17.79分、familyをまたぐtransitionでは23.69分でした。
十分な観測数を持つpairについて、Ground Truth expected pair lossとobserved pair median lossのSpearman correlationは0.995でした。
また、同じ2品種でも方向を逆にしたbidirectional pair間のmedian absolute differenceは9.04分でした。今回のDGPでは、P03→P04とP04→P03のようなreverse transitionを同じものとして扱えない構造になっています。
Cumulative loss上位15%のdirected pairだけで、全cumulative changeover lossの39.1%を占めました。最大のcumulative-loss pairはP12→P10で、21回、median loss 42.05分、cumulative loss 891.3分でした。
この構造をどう解釈するか
今回のGround Truthでは、changeover lossを前後品種の属性差から生成しています。
Tool groupやmaterial groupが変わるとsetup timeを加算し、residue classが高い品種から低い品種へ替える場合にはcleaningを重くしています。逆方向では同じcleaning penaltyを課していません。
Temperature setpointも方向を持ち、今回のDGPではcoolingをheatingより時間がかかる設定にしています。さらに一部pairへ追加のincompatibility costを入れました。
その結果、product単独の特性だけでなく「どのproductの次に置かれたか」がlossへ影響します。From / To productのmain effectだけでtransition-level lossを説明したadditive baselineのR²は0.674で、pair interactionを残す設計になっています。
可視化の仕組み
まず1,200 runのproduct sequenceを生成し、そこから1,199個のdirected transitionを作りました。
各transitionでは、tool change、material change、family change、residue cleanup、temperature adjustment、pair-specific incompatibilityからsetup downtimeを生成します。さらにstartup stabilization lossを等価時間として加え、total changeover lossを計算します。
Matrixはpairごとのmedian total lossとcountを保持します。Network側では、各pairのtotal lossをsequence全体で合計し、そのcumulative lossが大きい18 pairだけを選択しています。
Matrixとnetworkでproduct orderとcolor scaleを共有しているため、あるedgeがどのmatrix cellへ対応するかを行き来して読むことができます。
なぜこの可視化方法を選んだのか
Matrixは、前品種と次品種のすべての組み合わせを規則的に比較することに向いています。一方、全pairをmatrixだけで見ると、頻度まで含めて生産全体へ大きな影響を持つtransitionが視覚的に埋もれることがあります。
Networkは関係の強さをflowとして見せることに向いていますが、12品種の全directed pairをedgeとして描けば密度が高くなり、個々の値の比較が難しくなります。
今回のhybridでは、全pairをmatrixへ残し、重要なcumulative-loss relationだけをnetworkへ選択的に持ち上げています。それぞれの表現が持つ役割を分けながら、一つのcompositionとして統合しています。
実データへの応用可能性
実データでは、生産順序、前品種、次品種、段取り開始・終了timestamp、立上げロス、設備IDなどがあれば、同様の構造を探索できる可能性があります。
たとえば平均段取り時間だけでは目立たないものの、特定の「A→B」が頻繁に発生することで累積損失を大きくしていないか、あるいはA→BとB→Aに方向非対称性がないかを確認できます。
実工程ではoperator、設備状態、lot condition、maintenance、production volumeも関係するため、matrix-networkは原因確定ではなく、追加分析すべきpairを見つけるための仮説形成に利用できます。
データと分析方法
今回はSynthetic Dataを使用しています。品種数12、production runs 1,200、changeover数1,199、乱数シードは260927です。
各品種にはfamily、tool group、material group、residue class、temperature setpointを持たせています。Changeoverごとにsetup downtimeとstartup stabilization lossの等価時間を生成し、その合計をtotal lossとしました。
分析ではpair median、transition count、cumulative loss、bidirectional asymmetry、Ground Truth expected lossとのcorrelation、From / To main-effects baselineを計算しています。
このVisualization Studyの限界
今回のloss structureはSynthetic Dataとして設計したものです。実際の工場で同じ品種属性やpenaltyが存在することを示すものではありません。
特にcleaning、temperature adjustment、pair-specific incompatibilityの大きさは今回のData Generating Processへ依存します。またstartup lossを時間へ換算する方法も実工程では生産速度や製品価値によって変わります。
Networkではcumulative loss上位18 pairだけを選択しているため、matrixに存在するすべてのrelationを外周edgeへ表示しているわけではありません。
さらに、pair間のloss差は観測されたrelationであり、実データへ適用した場合にproduct pair自体の因果効果と断定することはできません。Sequence schedulingや設備・operatorなどのconfoundingを追加で検討する必要があります。
まとめ
今回は、段取り替え損失を単一の平均時間ではなく「前品種→次品種」のdirected relationとして捉え、Changeover transition matrix-network hybridで可視化しました。
Synthetic Dataでは、pairによってlossが大きく異なり、reverse directionにも差が残りました。また、頻度を含めて見ると一部のdirected pairへcumulative lossが集中しました。
この見方は、段取り時間の長短だけではなく、どの品種の組み合わせがどの方向で繰り返されているかまで含めて、生産sequenceのloss structureを探索するための一つの方法になります。