
製造トレーサビリティでは、ある原材料ロットがどの製品へ使われたかを追跡する必要があります。しかし実際の系譜は、原材料から製品へ一直線につながるとは限りません。中間混合や製造バッチを経て複数ロットへ分岐し、別の経路が再び同じ製品ロットへ合流する場合があります。今回は、この複雑さをLot genealogy flow networkとして可視化しました。
この図は何を表しているのか
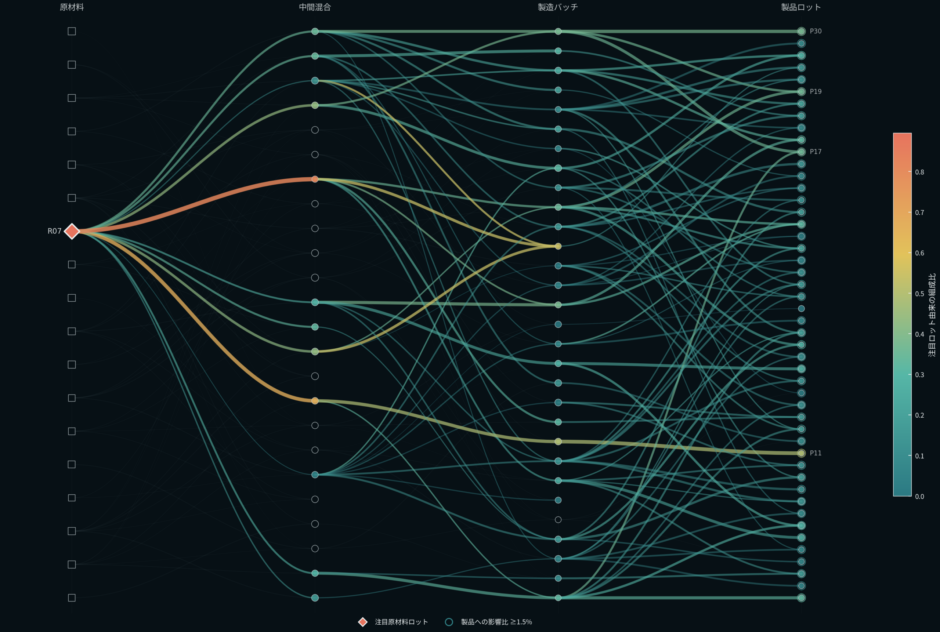
図は左から原材料、中間混合、製造バッチ、製品ロットの4段階で構成されています。Nodeは個々のlot、edgeは「どのlotが次工程のどのlotへ使われたか」を表します。
背景に薄く広がるedgeはgenealogy全体です。強く色づいたedgeは、注目した原材料ロット R07 のcompositionが下流へ伝播する経路です。
Accent colorは下流lotに含まれるfocal-lot composition fractionを表し、edge widthもそのcontributionに応じて変化します。右端のProductでhaloが付いたnodeは、今回のanalysis thresholdである1.5%以上のfocal compositionを持つlotです。
注目原材料はdiamondで示しています。Scientific版ではcomposition fractionのscaleと、影響割合が特に高い一部Product IDを追加しています。
可視化から読み取れること
Genealogy全体は120 nodes、236 edgesで構成されています。内訳は原材料18 lot、中間混合24 lot、製造バッチ30 lot、製品48 lotです。
注目した R07 は直接12個のPremixへ使われています。1.5%以上というthresholdで追跡すると、その影響範囲はPremix 12 lot、Batch 28 lot、Product 47 lotまで広がりました。Productでは全48 lotの97.9%に相当します。
Compositionがわずかでも含まれるProductまで含めると、48 lotがfocal raw lotのdescendantでした。つまりthresholdの設定によって「追跡範囲」の見え方も変わります。
さらに、thresholdを超えたProductのうち41 lot、87.2%では、focal raw lotから2本以上のdistinct pathが同じProductへ合流していました。単純な枝分かれだけでなく、系譜の再合流が起きています。
この構造をどう解釈するか
今回のSynthetic Dataでは、child lotを複数parent lotのweighted mixtureとして生成しています。
Focal raw lot R07 は最初に複数Premixへ分岐します。その後、それぞれのPremixが別のBatchへ使われ、Batchも複数Productへつながります。
一方、BatchやProductは複数parentを持てるため、別々に分かれたfocal lineageが後段で同じlotへ再び合流します。その場合、focal contributionは各parentからのcontributionを加算して求めます。
このため影響範囲は単純なtreeではなく、branchingとmergingを含むdirected acyclic graphとして扱う必要があります。
可視化の仕組み
各edgeにはtarget lotに占めるparent fractionを持たせています。各child lotのincoming fractionは合計1.0になるよう正規化しています。
Focal raw lotのexposureを1.0、その他のRaw lotを0として開始し、stage順に parent exposure × fraction を伝播します。複数parentからfocal contributionが届く場合には加算します。
同時にpath countも伝播し、一つのProductへfocal influenceが何本のdistinct pathから到達したかを計算しています。
Layoutでは、4 stageの横位置を固定し、各stage内のlotをparent位置のweighted averageに基づくbarycentric orderingで並べています。これによりedge crossingをある程度抑えながら、genealogyの流れを維持しています。
なぜこの可視化方法を選んだのか
表形式で「原材料lot → Product lot」を一覧化すれば、個々のtraceability relationは確認できます。一方、分岐・合流が多数存在すると、どの段階で影響範囲が広がったか、別経路がどこで再び合流したかは把握しにくくなります。
Lot genealogy flow networkでは、production stageを保持したままedge flowを追えるため、branchingとmergingを同じ図で表現できます。
また、全genealogyを背景として残しながらfocal lineageだけを強調することで、影響範囲をnetwork全体の中で位置づけられます。
実データへの応用可能性
実データでは、原材料lot ID、中間lot ID、製造batch ID、Product lot ID、投入量や配合比、production timestampなどがあれば、同様のgenealogy structureを構築できる可能性があります。
たとえば特定の原材料lotについて、直接使用された次工程だけでなく、複数stageを越えたdownstream productまでtraceし、どのProductへどの程度のcomposition contributionが届いているかを探索できます。
また、回収や調査の対象範囲を検討する際に、どの段階で系譜が大きくbranchしたか、どこで複数経路がmergeしたかを確認するためのデータ探索にも利用できます。
ただし、実際の回収判断や品質判断には法令、危害評価、検査結果、使用量、製造条件など追加情報が必要です。Genealogyだけで対象範囲を決定できるわけではありません。
データと分析方法
今回はSynthetic Dataを使用しています。原材料18、Premix 24、Batch 30、Product 48、総node数120、総edge数236、乱数シードは260927です。
各child lotを1〜4個のparent lotから生成し、edgeへcomposition fractionを付与しています。注目原材料lotを R07 とし、weighted propagationによってdownstream exposureとpath countを計算しました。
今回の「影響範囲」はfocal compositionが1.5%以上のlotを主要対象として可視化しています。このthresholdは本Study用のanalysis definitionです。
このVisualization Studyの限界
今回のlot genealogyはSynthetic Dataとして設計したものです。実際の生産工程で同じlot数、branching rate、merge rate、composition fractionが存在することを示すものではありません。
また、focal_exposureは材料組成上のlineage contributionであり、品質不良や危害の大きさそのものを表しません。少量の混入でも重要なケースもあれば、composition fractionと品質影響が単純比例しないケースもあります。
今回使用した1.5% thresholdもVisualization Study上の設定であり、実務上の安全基準や回収基準ではありません。
さらに、実データではrework、再投入、分割、廃棄、戻し原料などによってcycleが生じる場合があり、今回のDAGより複雑になる可能性があります。
まとめ
今回は、原材料ロットの影響が下流でどのように分岐し、再び合流するかをLot genealogy flow networkとして可視化しました。
Synthetic Dataでは、1つの原材料lotから始まった系譜が複数の中間lotやbatchへ広がり、Product段階では複数pathが同じlotへ収束する構造が現れました。
この見方は、lot traceabilityを単純な対応表として見るだけでなく、影響範囲がどのstageで広がり、どこで複雑化しているかをnetwork structureとして探索するための一つの方法になります。