
はじめに
企業でAI活用が進むにつれて、AIモデルの精度や便利さだけでなく、AIセキュリティをどう考えるかが重要になっています。
AIセキュリティというと、高度な攻撃手法や専門的な防御技術を想像するかもしれません。
しかし、企業実務で最初に考えるべきことは、必ずしも難しい攻撃対策ではありません。
むしろ、まずは自社で使うデータの出所、ラベル品質、評価方法、運用時の入力変化、誤判定時の確認フローを整理することが重要です。
AIモデルは、人間と同じように画像やデータを理解しているわけではありません。
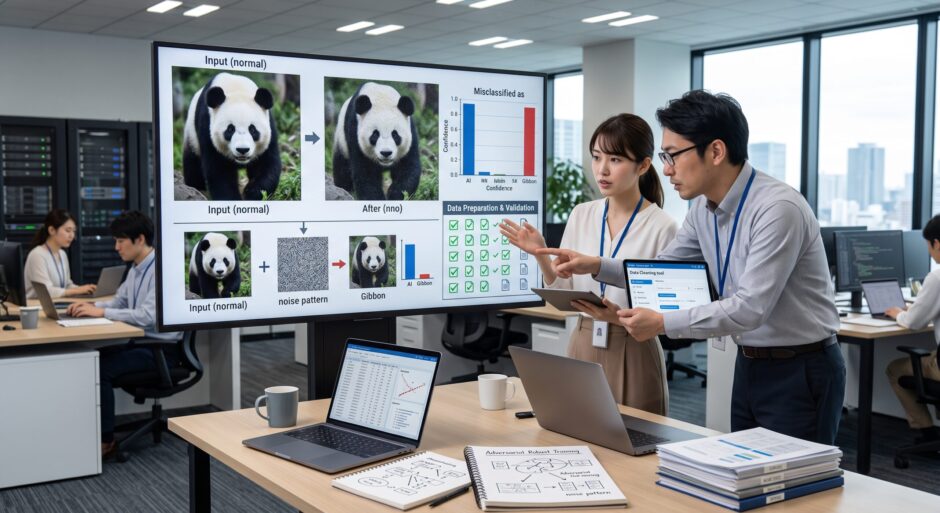
そのことを分かりやすく示す有名な例が、パンダの画像がテナガザルとして誤分類される敵対的サンプルです。
この例では、人間にはほぼ同じパンダ画像に見えるにもかかわらず、AIモデルが高い信頼度で別の動物として分類してしまいます。
本記事では、この有名事例を入口に、敵対的サンプル、データポイズニング、バックドア攻撃などの基本概念を整理します。
そのうえで、AIセキュリティを企業で考える際に、なぜデータ整備が出発点になるのかを解説します。
AIセキュリティとは何か
AIセキュリティとは、AIモデル、学習データ、入力、出力、運用環境に関するリスクを管理する考え方です。
通常の情報セキュリティでは、ネットワーク、サーバー、端末、アカウント、アクセス権限などが主な対象になります。
AIセキュリティでは、それに加えて、次のような要素も対象になります。
| 対象 | 確認すべきこと |
|---|---|
| 学習データ | 出所、利用権限、品質、ラベル、偏り |
| 評価データ | 学習データと分離されているか、現場条件を反映しているか |
| モデル | 入手元、更新履歴、評価結果、想定外入力への挙動 |
| 入力データ | 運用時の画像、文章、数値データが学習時と異なっていないか |
| 出力結果 | 誤判定時にどう確認し、誰が判断するか |
| 運用環境 | モデル更新、ログ管理、監視、アクセス制御 |
NISTは、敵対的機械学習に関する分類・用語整理の中で、evasion、poisoning、privacy breachなど、AI・機械学習システムに固有の攻撃やリスクを整理しています(NIST, 2025)。
AIセキュリティは、サイバーセキュリティ部門だけの話ではありません。
DX担当、事業部門、データ担当、情報システム部門、ベンダー管理担当が共同で考えるべきテーマです。
パンダがテナガザルに見える?敵対的サンプルの有名事例
AIセキュリティを理解するうえで有名なのが、Goodfellowらの敵対的サンプルの例です。
この例では、パンダの画像に人間には分かりにくい小さな変化を加えることで、AIモデルがパンダではなくテナガザルとして分類してしまいます。
重要なのは、ここで加えられる変化が、単なるランダムなノイズではないことです。
敵対的サンプルとは、AIモデルの誤分類を誘導するように設計された入力です。
Goodfellowらは、敵対的サンプルを、小さく意図的な最悪ケースの摂動を加えることで、モデルが高い信頼度で誤った答えを出す入力として説明しています(Goodfellow et al., 2015)。
ここでいう摂動とは、元のデータに加えられる小さな変化のことです。
人間にとってはほぼ同じ画像に見えても、AIモデルにとっては判断結果を大きく変える変化になる場合があります。
この例は、AIが画像を「人間と同じ意味」で理解しているわけではないことを示しています。
敵対的サンプルはなぜ問題になるのか
敵対的サンプルが問題になるのは、AIモデルの予測結果が、人間には分かりにくい入力変化によって大きく変わる可能性があるためです。
Szegedyらは、ニューラルネットワークに対して、人間にはほぼ認識できない摂動を加えることで誤分類を引き起こせることを示し、このような摂動が単なる学習上の偶然ではないことも報告しています(Szegedy et al., 2014)。
企業実務に置き換えると、これは次のような問題につながります。
| 業務例 | 想定されるリスク |
|---|---|
| 画像検査AI | 照明、反射、汚れ、圧縮などで判定が不安定になる |
| 異常検知AI | 通常時とは異なる入力条件で誤検知・見逃しが発生する |
| 文書分類AI | 入力文の一部表現の違いで分類が変わる |
| 需要予測AI | 学習時と運用時でデータ分布が変わり、予測精度が落ちる |
| AI PoC | 限られた評価データだけで性能を判断してしまう |
敵対的サンプルの研究は、意図的な攻撃を対象にすることが多いです。
一方で、企業実務では、悪意ある攻撃だけでなく、現場環境の変化やデータ品質のばらつきによって、AIモデルが想定外の挙動を示すこともあります。
そのため、AIセキュリティは「攻撃された場合」だけでなく、「入力が変わった場合にモデルがどの程度安定しているか」を確認する視点でも重要です。
AIセキュリティで考えるべき主な攻撃・リスク
AIセキュリティで扱うリスクには、いくつかの種類があります。
ここでは、企業のDX担当者が最低限押さえておきたいものに絞って整理します。
| リスク | 発生箇所 | 概要 |
|---|---|---|
| 敵対的サンプル | 推論時 | 入力に小さな変化を加え、誤分類を誘導する |
| evasion attack | 推論時 | モデルの判定を回避するように入力を操作する |
| データポイズニング | 学習前・学習時 | 学習データに不正・誤ったデータを混入する |
| バックドア攻撃 | 学習済みモデル | 特定条件でだけ誤動作する挙動を仕込む |
| model supply chain risk | モデル入手・外部委託時 | 外部モデル、学習済みモデル、委託学習に伴うリスク |
| 分布シフト | 運用時 | 学習時と運用時で入力データの性質が変わる |
BiggioとRoliは、敵対的機械学習の研究の発展を整理し、機械学習システムのセキュリティ評価では、攻撃者の能力や目的、評価条件を明確にすることが重要であると論じています(Biggio and Roli, 2018)。
ここで重要なのは、攻撃名を覚えることではありません。
どの段階でリスクが発生するのかを理解することです。
AIシステムは、データを集め、ラベルを付け、学習し、評価し、運用し、更新する一連の流れの中で使われます。
したがって、AIセキュリティもモデル単体ではなく、データから運用まで含めて考える必要があります。
データポイズニングとバックドア攻撃
AIセキュリティでは、推論時の攻撃だけでなく、学習データや学習済みモデルに関するリスクも重要です。
データポイズニング
データポイズニングとは、学習データに誤ったデータや不正なデータを混入させることで、モデルの挙動を歪める攻撃です。
たとえば、画像分類AIの学習データに誤ったラベルが混ざると、モデルは誤った対応関係を学んでしまう可能性があります。
悪意がなくても、ラベル定義が曖昧だったり、確認不足のデータが混ざったりすれば、似たような問題が起こります。
そのため、企業実務では、攻撃対策としてだけでなく、AI品質管理としてデータの出所やラベル品質を確認する必要があります。
バックドア攻撃
バックドア攻撃とは、通常時は問題なく動作するように見えるものの、特定の入力条件でだけ意図しない挙動を示すようにモデルへ仕込みを行う攻撃です。
Guらは、外部委託学習や学習済みモデルの利用において、悪意ある学習済みモデルが通常の検証データでは高性能に見えながら、特定の入力では攻撃者が意図した挙動を示す可能性を示しました(Gu et al., 2017)。
これは、外部モデルや学習済みモデルを利用する企業にとって重要な示唆があります。
モデルの精度だけでなく、モデルの入手元、学習履歴、利用条件、更新履歴を確認する必要があります。
企業実務で起きやすいAIセキュリティ上の課題
企業でAIを導入する際、最初から高度な敵対的攻撃を受けるとは限りません。
むしろ、実務上は次のような課題の方が先に出てきます。
| 課題 | 内容 |
|---|---|
| データの出所が曖昧 | どこで取得したデータか分からない |
| ラベル定義が不明確 | 正常・異常、不良・良品などの基準が揺れる |
| 評価データが偏っている | PoC時のテストデータが現場条件を十分に反映していない |
| 学習時と運用時の差 | 照明、角度、季節、設備状態などが変わる |
| 外部モデルへの依存 | 学習済みモデルの入手元や更新履歴が不明 |
| 誤判定時の対応不足 | AIの出力を誰が確認し、どう判断するか決まっていない |
これらは、いわゆる攻撃手法とは異なります。
しかし、AIモデルを安全かつ信頼して業務で使うためには、こうした実務上の管理が欠かせません。
OWASP Machine Learning Security Top 10でも、Data Poisoning Attackなど、機械学習システム特有のリスクが整理されています。
AIセキュリティは、まずデータ整備から始める
AIセキュリティという言葉から、難しい防御アルゴリズムを想像する必要はありません。
企業が最初に取り組むべきことは、データ整備です。
ここでいうデータ整備とは、単にデータをきれいにすることだけではありません。
次のような項目を含みます。
| 確認項目 | 内容 |
|---|---|
| データの出所 | 自社取得か、外部提供か、ベンダー提供か |
| 利用権限 | 学習・評価・商用利用に使えるか |
| ラベル定義 | 何を正常・異常・不良・良品とするか |
| ラベル品質 | 誰が付け、誰がレビューしたか |
| 評価データ | 学習データと分離されているか |
| 運用データ | 学習時のデータと条件が近いか |
| 更新履歴 | データやモデルの更新が記録されているか |
| 誤判定対応 | AIの出力を誰が確認し、どう扱うか |
AIモデルの性能は、学習データや評価データに大きく依存します。
データの出所が不明確で、ラベル定義が曖昧で、評価データが偏っている状態では、モデル精度の数字だけを見ても、実務で信頼できるか判断しにくくなります。
CarliniとWagnerは、ニューラルネットワークのロバスト性評価において、防御手法が既存の攻撃に対して有効に見えても、より強い評価では破られる可能性があることを示しました(Carlini and Wagner, 2017)。
これは企業実務にも通じます。
「対策を入れたから安全」と考えるのではなく、どのデータで、どの条件で、どのリスクに対して評価したのかを確認する必要があります。
AI導入前に確認すべきチェックリスト
AIセキュリティを考える際、まずは次の項目を確認するとよいでしょう。
| チェック項目 | 確認内容 |
|---|---|
| 学習データの出所 | 自社取得、外部提供、ベンダー提供のどれか |
| データ利用権限 | 学習・評価・商用利用に使えるか |
| ラベル定義 | 判断基準が文書化されているか |
| ラベル品質 | レビュー済みか、担当者間で基準が揃っているか |
| 評価データ | 学習データと分けているか |
| 現場条件 | 運用時の入力が学習時と大きく異ならないか |
| 外部モデル | 入手元、ライセンス、更新履歴を確認しているか |
| モデル更新 | いつ、誰が、どのデータで更新するか |
| 入力監視 | 運用中の入力変化を確認できるか |
| 誤判定対応 | AIの出力を人間が確認するフローがあるか |
| ベンダー説明 | データ管理、評価、運用について説明を受けているか |
このチェックリストは、AI活用を止めるためのものではありません。
むしろ、AIを業務で使いやすくするためのものです。
データや評価の前提が整理されていれば、ベンダー提案の確認、PoC設計、社内説明、運用ルール整備が進めやすくなります。
まとめ:AIセキュリティは攻撃対策だけでなく、データと運用の管理である
AIセキュリティは、敵対的サンプルやデータポイズニングといった攻撃手法だけを扱うものではありません。
AIモデル、学習データ、評価データ、入力、出力、運用環境を含めて、AIを安全かつ信頼して使うための管理です。
パンダ画像がテナガザルとして誤分類される有名な例は、AIモデルが人間と同じように画像を理解しているわけではないことを示しています。
人間にはほぼ同じ画像に見えても、AIモデルにとっては判断結果を大きく変える入力になる場合があります。
企業実務では、このような高度な攻撃手法だけでなく、データの出所、ラベル品質、評価データ、運用時の入力変化、誤判定時の確認フローを整えることが重要です。
AIセキュリティの第一歩は、難しい防御アルゴリズムを導入することではありません。
まずは、自社のAI活用状況とデータ管理状況を棚卸しすることです。
自社のAI活用やデータ整備の方向性を相談したい場合は、SCI総合研究所の KAMUSHIRUBE をご活用ください。
AIモデルのセキュリティ対策、データ取得・ラベル設計、評価設計、PoC、実証実験の整理を進めたい場合は、KANAMEBA もご検討ください。
お問い合わせは、お問い合わせフォーム よりご連絡ください。
参考文献
- Szegedy et al. 2014. Intriguing properties of neural networks. International Conference on Learning Representations. arXiv:1312.6199. https://arxiv.org/abs/1312.6199
- Goodfellow et al. 2015. Explaining and Harnessing Adversarial Examples. International Conference on Learning Representations. arXiv:1412.6572. https://arxiv.org/abs/1412.6572
- Biggio and Roli. 2018. Wild patterns: Ten years after the rise of adversarial machine learning. Pattern Recognition. Vol. 84. pp. 317-331. https://doi.org/10.1016/j.patcog.2018.07.023
- Carlini and Wagner. 2017. Towards Evaluating the Robustness of Neural Networks. IEEE Symposium on Security and Privacy. pp. 39-57. https://doi.org/10.1109/SP.2017.49
- Gu et al. 2017. BadNets: Identifying Vulnerabilities in the Machine Learning Model Supply Chain. arXiv:1708.06733. https://arxiv.org/abs/1708.06733
- NIST. 2025. Adversarial Machine Learning: A Taxonomy and Terminology of Attacks and Mitigations. NIST Trustworthy and Responsible AI Report. https://doi.org/10.6028/NIST.AI.100-2e2025
- OWASP Foundation. 2023. OWASP Machine Learning Security Top 10. https://owasp.org/www-project-machine-learning-security-top-10/