
はじめに
画像認識AIを使った検品、設備点検、監視カメラ分析、人数カウント、店舗棚分析などを検討していると、YOLOという名前を目にすることがあります。
YOLOは、You Only Look Onceの略で、画像や動画から対象物の位置と種類を検出する物体検出アルゴリズムの代表的な系譜です。
特に、リアルタイム物体検出の文脈でよく使われます。
ただし、YOLOを「画像を入れれば何でも検出できるAI」と理解すると、実務では失敗しやすくなります。
YOLOで扱うのは、画像の中に「何があるか」だけではありません。
どこにあるか、どの程度の確信度で検出されたか、誤検出や見逃しをどこまで許容できるか、現場でどう確認するかまで含めて考える必要があります。
また、YOLOには多くのバージョンがあります。
YOLOv1、YOLOv2、YOLOv3、YOLOv4、YOLOX、YOLOv7、YOLOv9、YOLOv10、YOLO11など、数字や名称が増えており、単純に「数字が大きいほど優れている」とは言えません。
本記事では、YOLOの基礎アルゴリズム、代表的な変遷、ビジネスでの活用例、導入時の注意点を論文ベースで整理します。
YOLOとは何か
YOLOは、画像全体を一度に処理し、物体の位置とカテゴリを同時に予測する物体検出アルゴリズムです。
Redmonらが発表したYOLOv1では物体検出を、バウンディングボックスとクラス確率を画像全体から直接予測する単一の回帰問題として扱いました。これにより、従来の複雑な検出パイプラインと比べて、リアルタイム性を重視した物体検出が可能になりました(Redmon et al., 2016)。
物体検出では、主に次の2つを推定します。
| 推定するもの | 内容 |
|---|---|
| 物体の位置 | 画像内のどこにあるか。通常はバウンディングボックスで表す |
| 物体の種類 | 人、車、製品、傷、ラベル、部品などのカテゴリ |
つまり、YOLOは「この画像は犬です」と分類するだけではありません。
画像内のどこに犬がいるのか、複数の物体がある場合はそれぞれがどこにあるのかを検出します。
この点が、通常の画像分類と大きく異なります。
画像分類・物体検出・セグメンテーションの違い
画像AIには、画像分類、物体検出、セグメンテーションなど複数のタスクがあります。
YOLOを理解するには、まずこれらの違いを整理しておくと分かりやすくなります。
| タスク | 目的 | 出力例 | 業務例 |
|---|---|---|---|
| 画像分類 | 画像全体が何かを分類する | 正常品 / 不良品 | 製品画像の良否分類 |
| 物体検出 | 画像内の物体の位置と種類を検出する | 傷の位置、部品の位置 | 外観検査、人数カウント |
| セグメンテーション | 物体領域をピクセル単位で分ける | 欠陥領域の輪郭 | 精密な異常範囲の抽出 |
YOLOが主に扱うのは、物体検出です。
たとえば、製品画像の中に傷があるかどうかだけでなく、傷がどこにあるかを矩形で示します。
小売店舗であれば、棚にある商品の位置を検出できます。
設備点検であれば、メーター、ランプ、異常候補箇所などを検出対象にできます。
ただし、検出できるかどうかは、画像品質、撮影条件、対象物の見た目、アノテーション品質に大きく左右されます。
YOLOの基礎アルゴリズム
YOLOの基本的な考え方は、画像を一度だけ見て、物体の位置と種類をまとめて予測することです。
初期のYOLOでは、画像をグリッドに分け、それぞれの領域が物体を含むか、どの位置にバウンディングボックスを置くか、どのクラスに属するかを予測します。
代表的な要素は次のとおりです。
| 要素 | 意味 |
|---|---|
| バウンディングボックス | 物体を囲む矩形 |
| クラス確率 | 検出対象がどのカテゴリに属するかの確率 |
| confidence score | 物体が存在する確信度と位置の確からしさ |
| IoU | 予測ボックスと正解ボックスの重なり具合 |
| NMS | 重複して検出されたボックスを整理する後処理 |
| mAP | 物体検出モデルの性能評価で使われる代表的な指標 |
YOLOでは、同じ物体に対して複数のボックスが出ることがあります。
そのため、多くのYOLO系モデルでは、Non-Maximum Suppression(NMS)という後処理で、重複する検出結果を整理します。
ただし、近年はNMSへの依存を減らす、またはNMS-freeを目指す流れもあります。
たとえばYOLOv10は、NMSへの依存がend-to-end展開や推論遅延の面で課題になるとして、NMS-free trainingと効率・精度を両立する設計を提案しています(Wang et al., 2024)。
YOLOシリーズの変遷
YOLOシリーズの変遷は、単純なバージョンアップではありません。
研究論文として追いやすい系譜、実装として広く使われる系譜、派生モデルが混在しています。
そのため、記事や提案書でYOLOを扱う際は、「どのYOLOを指しているのか」を明確にする必要があります。
| 系譜 | 主なモデル | 大まかな特徴 |
|---|---|---|
| 初期YOLO系 | YOLOv1、YOLOv2、YOLOv3 | リアルタイム物体検出、精度・速度改善、マルチスケール化 |
| 実用性強化系 | YOLOv4、YOLOX、YOLOv7 | 学習テクニック、ネットワーク構造、実装・推論効率の改善 |
| 近年の研究系 | YOLOv9、YOLOv10 | 勾配情報、NMS-free、効率・精度境界の改善 |
| 実装・プロダクト系 | YOLOv5、YOLOv8、YOLO11 | 実装容易性、タスク拡張、ドキュメント整備 |
YOLOを導入検討する場合、重要なのは「最新の数字」だけではありません。
現場で必要な速度、精度、データ量、モデルサイズ、推論環境、運用体制に合っているかを確認することです。
YOLOv1:リアルタイム物体検出の出発点
YOLOv1は、物体検出を単一のニューラルネットワークで処理する統一的なアプローチとして提案されました。
従来の物体検出では、候補領域を生成してから分類するなど、複数段階の処理を組み合わせる方法が多く使われていました。
一方、YOLOv1は、画像全体からバウンディングボックスとクラス確率を直接予測する設計です。
この考え方により、YOLOv1は高速な物体検出を実現しました。
YOLOv1の重要な意義は、物体検出をリアルタイム処理しやすい形に整理した点にあります。
一方で、小さな物体や密集した物体の検出には課題がありました。
この課題は、その後のYOLOシリーズで、マルチスケール検出、特徴抽出ネットワーク、アンカー、ヘッド構造、データ拡張などの形で改良されていきます。
YOLOv2・YOLOv3:精度と速度の改善
YOLOv2は、YOLO9000として発表され、速度と精度の改善、より多くのカテゴリへの対応を目指しました。
RedmonとFarhadiは、YOLOv2がマルチスケール学習により速度と精度のトレードオフを取りやすくなり、YOLO9000では検出データと分類データを組み合わせて多数カテゴリの検出に取り組んだと説明しています(Redmon and Farhadi, 2017)。
YOLOv3では、Darknet-53を用いた特徴抽出や、複数スケールでの検出などが取り入れられました。
YOLOv3の論文では、いくつかの設計変更により、速度を保ちながら精度を改善したことが示されています(Redmon and Farhadi, 2018)。
実務上は、YOLOv3以降の流れで、対象物の大きさがばらつく場合や、小さい対象物を検出したい場合に、マルチスケール検出の考え方が重要になります。
YOLOv4・YOLOX・YOLOv7:実用性と高性能化
YOLOv4は、速度と精度の両立を目指して、複数の工夫を組み合わせたモデルとして提案されました。
YOLOv4では、CSPDarknet53、SPP、PAN、Mosaic data augmentation、CIoU lossなど、多くの要素が組み合わされています。Bochkovskiyらは、YOLOv4を高速かつ高精度な物体検出器として提案し、一般的なGPU環境でも学習・利用しやすいことを意識した構成を示しています(Bochkovskiy et al., 2020)。
YOLOXは、YOLO系の実用的な改良として、anchor-free、decoupled head、SimOTAなどを導入しました。
Geらは、YOLOXでYOLO detectorをanchor-free方式に切り替え、decoupled headやSimOTAなどの技術を採用したと説明しています(Ge et al., 2021)。
YOLOv7は、trainable bag-of-freebiesを中心に、リアルタイム物体検出の性能向上を狙ったモデルです。
YOLOv7の論文はCVPR 2023で発表され、リアルタイム物体検出器として速度と精度の両立を主張しています(Wang et al., 2023)。
この時期のYOLO系モデルでは、単純なネットワーク拡大だけでなく、学習方法、データ拡張、特徴融合、ヘッド設計、推論速度の最適化が重要になっていきました。
YOLOv9・YOLOv10・YOLO11:近年の改良点と注意点
YOLOv9は、深いネットワークで情報が失われる問題に対し、Programmable Gradient Information、つまりPGIを提案しています。
Wangらは、PGIによって目標タスクに必要な入力情報を保持し、より信頼できる勾配情報を得ることを目指しています。また、GELANという軽量なネットワーク構造も提案しています(Wang et al., 2024)。
YOLOv10は、リアルタイムend-to-end物体検出を目指したモデルです。
YOLOv10では、NMSに依存する後処理が推論遅延やend-to-end展開の妨げになる点を課題として整理し、NMS-free trainingと効率・精度の両面を意識した設計を提案しています(Wang et al., 2024)。
YOLO11は、Ultralytics系のモデルとして広く使われています。
ただし、Ultralyticsは、YOLO11について正式な研究論文を公開していないと説明しています。そのため、論文ベースの記事では、YOLO11を「研究論文として検証されたYOLO系モデル」と同列に扱うのではなく、実装・ドキュメントが整備された実用系モデルとして位置づけるのが安全です。
このように、近年のYOLOは、単なる物体検出モデルから、デプロイ、マルチタスク、軽量化、後処理削減、エッジ環境での利用まで含めて議論されるようになっています。
YOLOで解けるビジネス課題
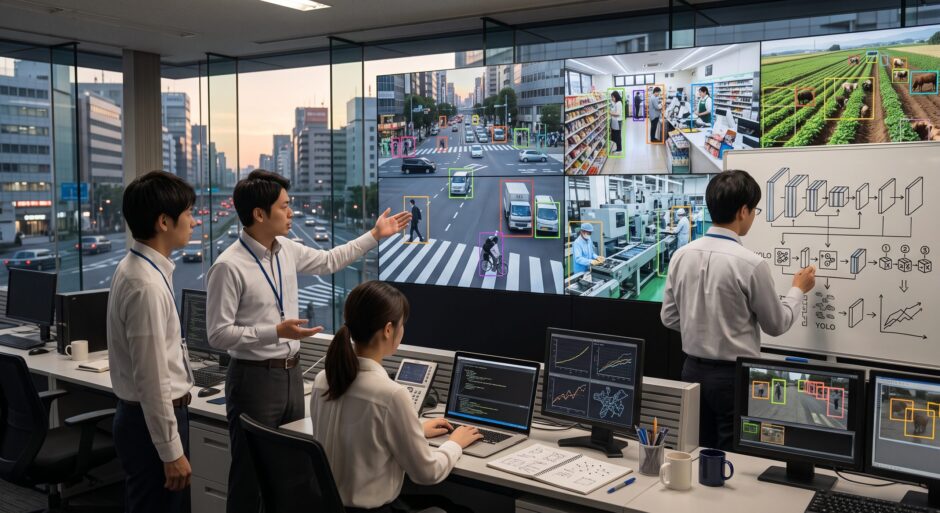
YOLOは、画像や動画の中から対象物を検出するため、さまざまな業務で活用できます。
ただし、ここでいう「解ける」とは、業務を完全に自動化できるという意味ではありません。
検出結果を業務判断の材料にする、確認作業を補助する、対象物の数や位置を記録する、といった使い方が現実的です。
| 業務領域 | 検出対象の例 | 活用イメージ |
|---|---|---|
| 製造業 | 傷、凹み、ラベル、部品 | 外観検査の補助、再検査対象の抽出 |
| 物流 | 荷物、パレット、車両 | 荷姿確認、積載状況の把握 |
| 小売 | 商品、棚札、欠品箇所 | 棚分析、陳列確認、欠品候補の検出 |
| 設備点検 | メーター、ランプ、異常箇所 | 点検画像の確認補助 |
| 建設・現場管理 | 作業員、重機、危険エリア | 安全確認、現場状況の記録 |
| 監視カメラ | 人、車両、侵入物 | 人流把握、警戒エリア検知 |
たとえば製造業の外観検査では、YOLOで傷や凹みの候補箇所を検出し、人が確認する運用が考えられます。
小売店舗では、棚画像から商品や棚札を検出し、欠品や陳列状態の確認に使える場合があります。
設備点検では、点検画像に写るメーターやランプの位置を検出し、読み取りや異常確認の前処理として活用できる可能性があります。
一方で、誤検出や見逃しが発生したときの業務影響を事前に整理しておく必要があります。
外観検査では、誤検出が多いと再検査工数が増えます。
一方、見逃しが多いと不良流出につながる可能性があります。
どちらを重視するかは、業務によって異なります。
YOLO導入前に確認すべきこと
YOLOを使う前に、まず確認すべきことはモデル名ではありません。
検出対象、画像条件、アノテーション、評価指標、運用方法です。
| チェック項目 | 確認内容 |
|---|---|
| 検出対象 | 何を検出したいのか明確か |
| 画像条件 | 照明、角度、距離、背景は安定しているか |
| データ量 | 学習・検証に使える画像が十分にあるか |
| アノテーション | 正解ラベルを誰がどの基準で付けるか |
| 評価指標 | mAP、precision、recallなど何を見るか |
| 誤検出 | 誤って検出した場合の業務影響は何か |
| 見逃し | 検出できなかった場合の業務影響は何か |
| 運用方法 | 人が確認するのか、自動処理につなげるのか |
| 更新方針 | 対象物や撮影条件が変わったときに再学習するか |
特に重要なのは、誤検出と見逃しの扱いです。
たとえば、監視カメラで人を検出する場合、誤検出が多いとアラート疲れにつながります。
外観検査では、見逃しが品質リスクになることがあります。
そのため、単にmAPが高いモデルを選ぶのではなく、業務上どのエラーを避けたいかを先に決める必要があります。
また、学習済みモデルをそのまま使える場合と、自社データで追加学習が必要な場合があります。
一般物体、たとえば人や車などは学習済みモデルである程度検出できることがあります。
一方で、自社製品の傷、独自部品、特殊な設備、特定の棚札などは、自社データでのアノテーションと学習が必要になることが多いです。
まとめ:YOLOはモデル名よりもデータ・評価・運用設計が重要
YOLOは、画像や動画から対象物の位置と種類を検出する物体検出アルゴリズムの代表的な系譜です。
YOLOv1は、物体検出を画像全体からバウンディングボックスとクラス確率を直接予測する問題として整理し、リアルタイム物体検出の流れを作りました。
その後、YOLOv2、YOLOv3、YOLOv4、YOLOX、YOLOv7、YOLOv9、YOLOv10などで、速度、精度、小物体検出、学習方法、特徴抽出、後処理などが改良されてきました。
一方で、YOLOシリーズは単一の公式系譜だけで発展しているわけではなく、研究論文として追いやすいモデルと、実装・プロダクトとして広く使われるモデルが混在しています。
そのため、YOLOを使う場合は、数字の大きさやモデル名だけで判断しないことが重要です。
実務では、次の点を整理する必要があります。
- 何を検出したいのか
- どのような画像条件なのか
- 十分な画像データがあるか
- アノテーション方針は決まっているか
- 誤検出と見逃しのどちらを重視するか
- 評価指標は何を見るか
- 現場でどのように使うか
- 導入後にどう更新・再学習するか
自社の画像データや物体検出AIの活用可能性を相談したい場合は、SCI総合研究所の KAMUSHIRUBE をご活用ください。
画像データや検査データの棚卸し、分析設計、評価指標の整理、可視化、レポート化まで進めたい場合は、RASHINRA もご検討ください。
お問い合わせは、お問い合わせフォーム よりご連絡ください。
参考文献
- Redmon et al. 2016. You Only Look Once: Unified, Real-Time Object Detection. Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition. pp. 779-788. https://doi.org/10.1109/CVPR.2016.91
- Redmon and Farhadi. 2017. YOLO9000: Better, Faster, Stronger. Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition. pp. 7263-7271. https://doi.org/10.1109/CVPR.2017.690
- Redmon and Farhadi. 2018. YOLOv3: An Incremental Improvement. arXiv. https://arxiv.org/abs/1804.02767
- Bochkovskiy et al. 2020. YOLOv4: Optimal Speed and Accuracy of Object Detection. arXiv. https://arxiv.org/abs/2004.10934
- Ge et al. 2021. YOLOX: Exceeding YOLO Series in 2021. arXiv. https://arxiv.org/abs/2107.08430
- Wang et al. 2023. YOLOv7: Trainable Bag-of-Freebies Sets New State-of-the-Art for Real-Time Object Detectors. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. pp. 7464-7475. https://openaccess.thecvf.com/content/CVPR2023/html/Wang_YOLOv7_Trainable_Bag-of-Freebies_Sets_New_State-of-the-Art_for_Real-Time_Object_Detectors_CVPR_2023_paper.html
- Wang et al. 2024. YOLOv9: Learning What You Want to Learn Using Programmable Gradient Information. European Conference on Computer Vision. arXiv. https://arxiv.org/abs/2402.13616
- Wang et al. 2024. YOLOv10: Real-Time End-to-End Object Detection. arXiv. https://arxiv.org/abs/2405.14458
- Ultralytics. YOLO11 documentation. https://docs.ultralytics.com/models/yolo11/