
物流拠点の混雑を考えるとき、規模の大きいセンターへ目が向きやすくなります。しかし、実際の物量集中は拠点の大きさだけでなく、どの経路がそこを通るか、そして何時に複数の流れが重なるかによって変わります。今回は、時間帯別のOD需要を物流networkへ流し、物流ボトルネックがどのように生まれるかを可視化しました。
この図は何を表しているのか
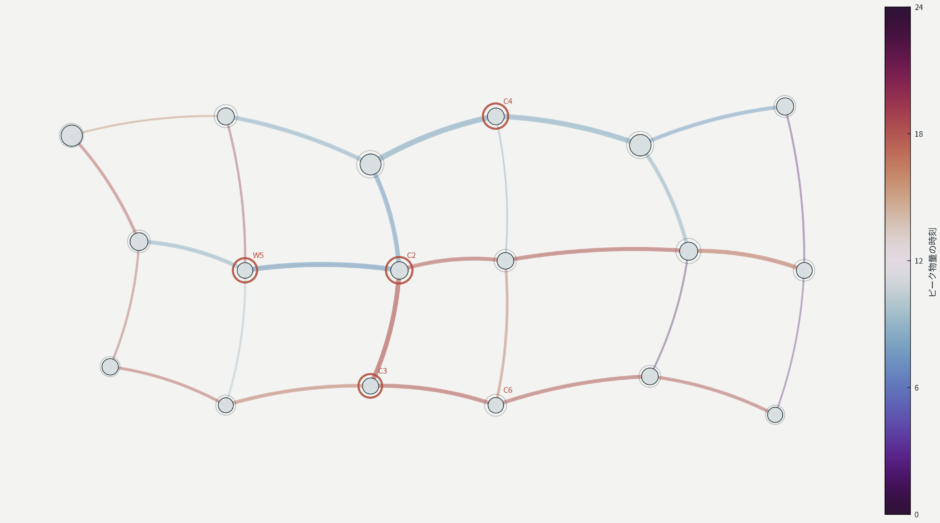
図中のnodeは物流拠点、edgeは拠点間の物流接続を表しています。
node本体の大きさはfacility sizeです。その外側のringはpeak utilizationを表し、capacityに対してピーク時にどれほど物量が集中したかを示します。特にbottleneck scoreが高いnodeではringを強く描いています。
edgeの太さはp95 flow、色はそのedgeで物量が最大となった時刻です。したがって、太いedgeが複数集まり、大きなringを持つnodeを見ると、規模だけでは説明できないflow concentrationを確認できます。
可視化から読み取れること
今回のSynthetic Dataでは、18拠点と27接続からなる物流networkを作り、53のOD relationを24時間にわたって流しました。
Facility sizeとpeak utilizationのSpearman相関は-0.27でした。一方、network上で多くの経路が通る程度を表すbetweennessとpeak utilizationの相関は0.72でした。
最大規模3拠点のうち、Top 5 bottleneckにも含まれたのは0拠点でした。今回の設定では、最大規模拠点とボトルネック拠点は必ずしも一致していません。
Top bottleneckはC2, W5, C3, C4, C6でした。これらはfacility sizeだけでなく、接続構造と時間帯別flowが重なった結果として高いbottleneck scoreを持っています。
この構造をどう解釈するか
今回のSynthetic Dataでは、西・中央・東の3地域を複数の物流edgeで結んでいます。ただし地域間の移動には中央部の限られたconnectorを通る必要があります。
さらに、西から東へ向かうflowは朝から昼、東から西は夕方、長距離幹線は夜間に強くなるようにOD demandを設計しました。
そのため、ある拠点のcapacityが大きいかどうかだけではなく、複数のOD pathがそこへ集まるか、同じ時間帯にflow peakが重なるかによってpeak utilizationが変わります。
可視化の仕組み
まず18物流拠点をSynthetic geography上に配置し、その上に地域内と地域間を結ぶedgeを設定しました。
次にOD relationごとに24時間のflow profileを与えました。各時間帯のOD demandはshortest pathへ割り当てられ、そのpathを通るedgeとnodeへloadとして加算されます。
nodeではpeak loadをcapacityで割り、peak utilizationを計算します。またnetwork structureからbetweenness centralityを算出しました。
Visualizationでは、facility sizeとpeak utilizationを同じnode sizeにまとめず、coreとringへ分離しています。これにより、「大きい拠点」と「混雑する拠点」を別の情報として比較できます。
なぜこの可視化方法を選んだのか
今回のテーマでは、拠点単体の指標だけでなく、地理的位置、network connection、flow magnitude、time-of-dayを同時に見る必要があります。
Spatiotemporal logistics flow networkでは、物流経路そのものを残しながら、edge widthへ物量、edge colorへ時間、nodeへfacility sizeとutilizationを重ねられます。
そのため、単純に大きな拠点を探すのではなく、network上のどこで時間的・構造的な集中が生じているかを探索できます。
実データへの応用可能性
実データでは、物流拠点、配送路線、時間帯別出荷量、入荷量、輸送実績、拠点capacityなどがあれば、同様の構造を探索できる可能性があります。
たとえば、大規模拠点ではないのに特定時間帯だけutilizationが高くなる拠点や、複数路線が集中するconnector、時間帯によってbottleneck位置が変わるnetworkなどを探索できます。
ただし、実際の物流ボトルネックには作業能力、車両待機、道路混雑、荷役時間、在庫制約など追加要因も関係します。
データと分析方法
今回はSynthetic Dataを使用しています。node数は18、edge数は27、OD relation数は53、時間帯は24時間です。乱数シードは260926です。
各OD relationへtime profileを設定し、その時間帯別需要をnetwork上のshortest pathへ割り当てました。nodeではfacility size、capacity、betweenness、peak utilizationを計算しています。
bottleneck scoreはpeak utilizationとbetweennessを組み合わせた探索用指標として使用しました。
このVisualization Studyの限界
今回のnetworkはSynthetic geographyであり、実際の道路網や物流拠点を表しているわけではありません。
Routingはshortest pathに固定しており、渋滞回避、複数経路への分散、配送時間制約、車両capacityなどは扱っていません。
また、bottleneck scoreは今回のVisualization Studyのために設計した探索指標であり、現実の物流停止リスクや損失額を直接表すものではありません。
そのため、このStudyは実際の物流ボトルネックを推定するモデルではなく、拠点規模・接続構造・時間帯flowをどのように同時可視化できるかを検討するものです。
まとめ
今回は、物流ボトルネックを拠点規模だけではなく、時間帯とnetwork connectivityから生まれるflow concentrationとして可視化しました。
Synthetic Dataでは、最大規模hubだけが高いpeak utilizationを持つわけではなく、中規模でも多くのpathが通り、特定時間帯に物量が重なる拠点がbottleneckとして現れています。
この見方は、実データでも単純な拠点規模ランキングだけでは見つけにくい物流集中点を探索し、追加分析すべき時間帯や接続関係について仮説を作るための入口として利用できます。