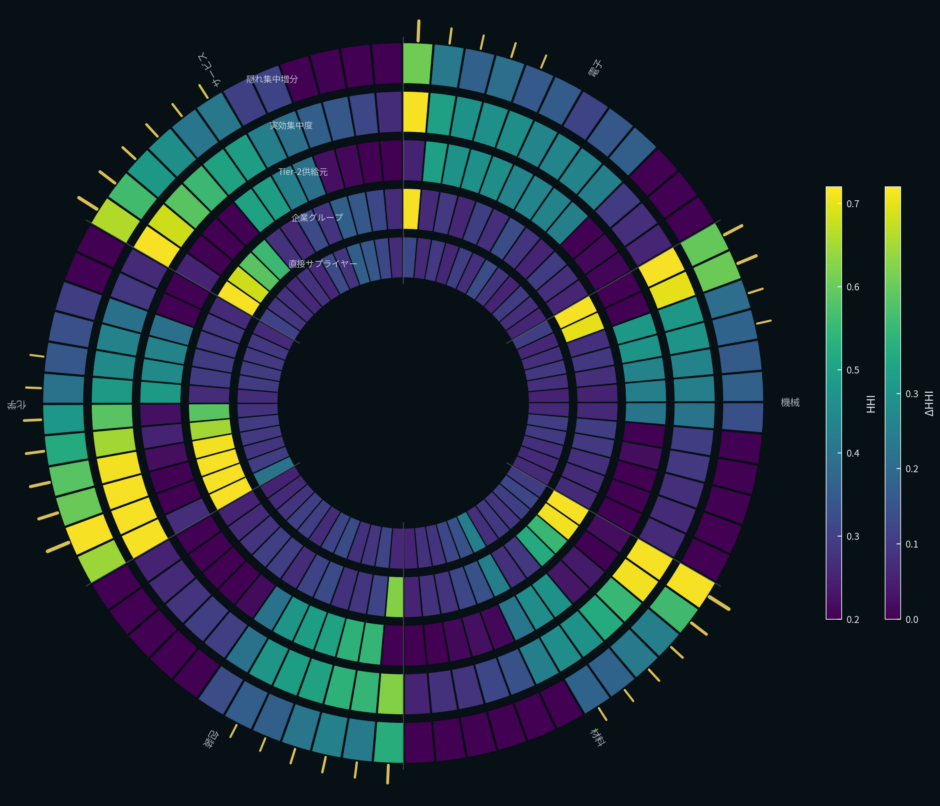

調達先の集中度を確認するとき、まず直接取引しているサプライヤー数や構成比を見ることが多いと思います。しかし、複数のサプライヤーが同じ企業グループに属していたり、同じ上流供給元へ依存していたりする場合、直接取引だけでは実際の依存構造を十分に捉えられません。今回は、品目ごとの集中を複数階層へ展開し、同心円状のradial matrixとして可視化しました。
この図は何を表しているのか
円周方向には72の品目が並んでいます。同じ品目は内側から外側まで同じ角度に配置されているため、半径方向を見ることで調達階層の変化を比較できます。
内側から、Direct supplier HHI、Corporate group HHI、Tier-2 source HHI、複数階層のうち最も高いEffective HHI、Direct layerからのHidden upliftを配置しています。色が明るいほど集中度が高いことを示します。最外周の短いmarkerは、Direct HHIが0.34未満にもかかわらず、上位階層ではHHIが0.45以上となったhidden dependency itemです。
可視化から読み取れること
今回のSynthetic Dataでは、72品目、36のTier-1 supplier、12のcorporate group、9のTier-2 sourceを生成しました。
Hidden dependencyと判定された品目は34品目でした。また、Direct layerではHHI 0.45未満だったにもかかわらず、階層集約後に0.45以上となった品目は35品目ありました。
HHIの逆数を「同程度に分散した供給元の実効数」として見ると、中央値はDirect supplier layerで3.55、最も集中したhierarchical layerでは2.27でした。
Direct HHIとUpstream HHIのSpearman相関は0.13で、直接supplierの集中度だけではupstream concentrationを完全には説明できない設定になっています。
この構造をどう解釈するか
今回のData Generating Processには3種類のlatent procurement modeを埋め込みました。
Upstream-hidden modeでは、異なるlegal supplier・異なるcorporate groupへ発注を分散しつつ、それらのsupplierが同じTier-2 sourceへ強く依存するようにしています。このmodeの平均Upstream HHIは0.46でした。
Group-hidden modeでは、複数のlegal supplierが同じcorporate groupに属する構造を作っています。このmodeの平均Group HHIは0.70でした。
一方、Dispersed modeではgroupとupstream sourceの両方を分散させ、平均Effective HHIは0.29でした。
可視化の仕組み
まず各品目に4つのTier-1 supplierを割り当て、shareを生成します。Direct HHIはそのlegal supplier shareの二乗和です。Corporate group HHIでは、同じ企業グループに属するsupplier shareを合算してからHHIを計算します。
Tier-2 source HHIでは、Tier-1 supplierがどの上流sourceから調達しているかをexposure matrixとして用意し、品目→Tier-1 shareと掛け合わせて品目ごとのupstream exposureを計算します。
Effective HHIは今回のVisualization StudyではDirect、Group、Upstreamのうち最も高いHHIを保守的なstructural concentrationとして採用しました。Hidden upliftはEffective HHIからDirect HHIを引いた値です。
なぜこの可視化方法を選んだのか
今回の現象は、一つの品目について複数の調達階層を比較する必要があります。同時に72品目全体のパターンも見たいという二つの粒度があります。
Supplier concentration radial matrixでは、品目を円周方向、調達階層を半径方向へ固定できます。そのため、ある品目について内側から外側へ集中が高まる様子と、品目群全体でそのパターンがどこに多いかを同じ図で扱えます。
実データへの応用可能性
実データでは、品目別の発注先と発注金額だけでなく、supplier group、親会社、主要なTier-2 supplier、原材料sourceなどの情報があれば、同様の構造を探索できる可能性があります。
たとえば、直接取引先は複数存在するものの親会社が共通している品目や、異なるTier-1 supplierが同じ原材料メーカーへ依存している品目などを探索できます。ただし、実際のdependency riskには代替可能性、在庫、地域、lead time、supplier capacityなども関係します。
データと分析方法
今回はSynthetic Dataを使用しています。品目数は72、Tier-1 supplier数は36、corporate group数は12、Tier-2 source数は9です。乱数シードは260926です。
各品目についてDirect supplier shareを生成し、Corporate groupへの集約とTier1→Tier2 exposure matrixによるupstream exposure計算を行いました。集中度にはshareの二乗和であるHHIを使用しています。Main Visualizationでは品目をfamily別に並べ、各family内ではEffective HHIが高い順にorderingしています。
このVisualization Studyの限界
今回の調達networkはSynthetic Dataとして設計したものです。実際の企業調達構造が同じ分布や集中度を持つことを示すものではありません。
Corporate groupは単純な所属関係、Tier-2 exposureも固定shareとして扱っています。現実には品目ごとにTier-1 supplierの上流調達先が異なる場合や、複数拠点・複数原材料へ分かれる場合があります。
また、Effective HHIとして複数階層の最大値を使用しているため、これは一般的な標準指標ではなく、今回のStudyで「どこか一つの階層に強い集中があるか」を探索するための定義です。
したがって、このVisualizationは実際の供給停止確率を直接推定するものではなく、直接調達だけでは見えにくいhierarchical concentrationを探索する方法を検討したものです。
まとめ
今回は、品目別の調達集中をDirect supplier、Corporate group、Tier-2 sourceへ展開し、Supplier concentration radial matrixとして可視化しました。
Synthetic Dataでは、直接supplierが分散して見える品目の一部で、上位階層へ集約すると集中度が高くなる構造が現れました。この見方は、実データでもsupplier数だけでは捉えにくい共通親会社や共通upstream sourceへの依存を探索し、追加確認すべき品目について仮説を作るための入口として利用できます。