
回帰分析で説明変数が多くなったり、似た動きをする変数が複数含まれたりすると、「通常の線形回帰だけでよいのか」「RidgeとLassoはどう使い分けるのか」という問題が出てきます。そのとき候補になる手法の一つがElastic Net(エラスティックネット)です。
Elastic Netは、Ridge回帰で使われるL2正則化と、Lasso回帰で使われるL1正則化を組み合わせた回帰モデルです。Lassoのように一部の係数を0にしながら、Ridgeの性質も取り入れられることが特徴です(Zou and Hastie, 2005)。ただし、「RidgeとLassoの中間だから常に優れている」という意味ではありません。データの構造、予測精度、係数の安定性、モデルを業務でどう使うかによって選択は変わります。
この記事では、Ridge・Lasso・Elastic Netの違いを整理した上で、架空の売上データに3手法を適用し、MAE、非ゼロ係数となった特徴量数、標準化後の回帰係数を比較します。記事中の数値と図はすべて説明用に生成した架空データに基づきます。
Elastic Netとは
Elastic NetはL1正則化とL2正則化を組み合わせた回帰モデル
正則化とは、モデルの学習時に係数の大きさへペナルティを加えることで、係数が過度に大きくなることを抑える考え方です。説明変数が多い場合や、説明変数同士に強い相関がある場合には、通常の最小二乗法で推定した係数がデータのわずかな変化に敏感になることがあります。Ridge回帰はL2正則化を利用し、このような状況で係数を縮小する代表的な方法です(Hoerl and Kennard, 1970)。
一方、Lasso回帰はL1正則化を利用します。L1正則化では、一部の係数がちょうど0になることがあり、結果としてモデルに残る変数を絞り込む性質があります(Tibshirani, 1996)。Elastic Netは、このL1とL2を同時に使うことで、係数の縮小と疎なモデルの両方を調整できるようにした方法です(Zou and Hastie, 2005)。
Ridge・Lassoとの違い
| 観点 | Ridge | Lasso | Elastic Net |
|---|---|---|---|
| 主な正則化 | L2 | L1 | L1+L2 |
| 係数の縮小 | 行う | 行う | 行う |
| 係数が0になる性質 | 通常は0になりにくい | 0になり得る | 0になり得る |
| 変数を残す傾向 | 広く残しやすい | 絞り込みやすい | L1/L2の配分で変化 |
| 主な調整値 | alpha | alpha | alpha、l1_ratio |
表だけを見るとElastic Netは「RidgeとLassoを足したもの」に見えますが、単純に2つのモデルの予測値を平均する手法ではありません。1つの目的関数の中でL1とL2のペナルティを組み合わせ、その配分を調整します。
alphaとl1_ratioの違い
scikit-learnのElasticNetでは、主にalphaとl1_ratioを調整します。alphaは正則化全体の強さを表し、大きくするほど係数を強く縮小します。l1_ratioはL1とL2の配分を決める値で、1に近いほどLasso寄り、0に近いほどRidge寄りになります。0より大きく1より小さいときに、L1とL2を組み合わせたElastic Netとして動作します。
ここで注意したいのは、alphaやl1_ratioに「業務で常に正しい固定値」があるわけではないことです。学習データだけで都合のよい値を選ぶのではなく、交差検証などを用いて未知データに対する性能を確認しながら設定します。本記事の比較でも、同じ学習データ、同じ前処理、同じ交差検証条件の中でパラメータを探索しています。
Ridge・Lasso・Elastic Netをどう使い分けるか
Ridge:説明変数を残しながら係数を縮小する
Ridge回帰は、説明変数を大きく削らずに係数を縮小したい場合の基本的な候補です。例えば、営業活動、広告、Web行動、価格、季節性など、業務上それぞれ意味を持つ変数をできるだけ残しながら予測モデルを安定させたい場合には検討しやすい方法です。
一方で、Ridgeの係数は通常、完全な0にはなりにくいため、「説明変数を少数に絞った簡潔なモデルがほしい」という目的にはそのままでは合わない場合があります。本記事でもRidgeの非ゼロ係数数は10個で、用意した10変数すべてに係数が残りました。
Lasso:一部の係数を0にして特徴量を絞る
Lasso回帰は、一部の係数を0にし得るため、説明変数の数を絞りながら線形モデルを構築したい場合に有用です。ただし、係数が0になったからといって、その変数が業務上不要である、あるいは目的変数と因果関係がないと判断できるわけではありません。Lassoがどの変数を残すかは、データの相関構造やalphaの設定にも影響されます。
Elastic Net:L1とL2の性質を組み合わせる
Elastic Netは、Lassoのように係数を0にする性質を持ちながら、L2正則化も組み合わせます。特に、互いに相関する説明変数が複数存在する場面は、Elastic Netを検討する理由の一つです。元論文では、Lassoが強く相関した変数群から一部を選びやすい問題に対し、Elastic Netが「grouping effect」と呼ばれる性質を持つことが議論されています(Zou and Hastie, 2005)。
ただし、「相関があれば必ずElastic Net」と機械的に決めるのは適切ではありません。Ridge・Lasso・Elastic Netを同じ評価条件で比較し、予測誤差とモデルの使いやすさを合わせて判断する方が実務的です。
相関の強い説明変数がある場合に何が起こるか
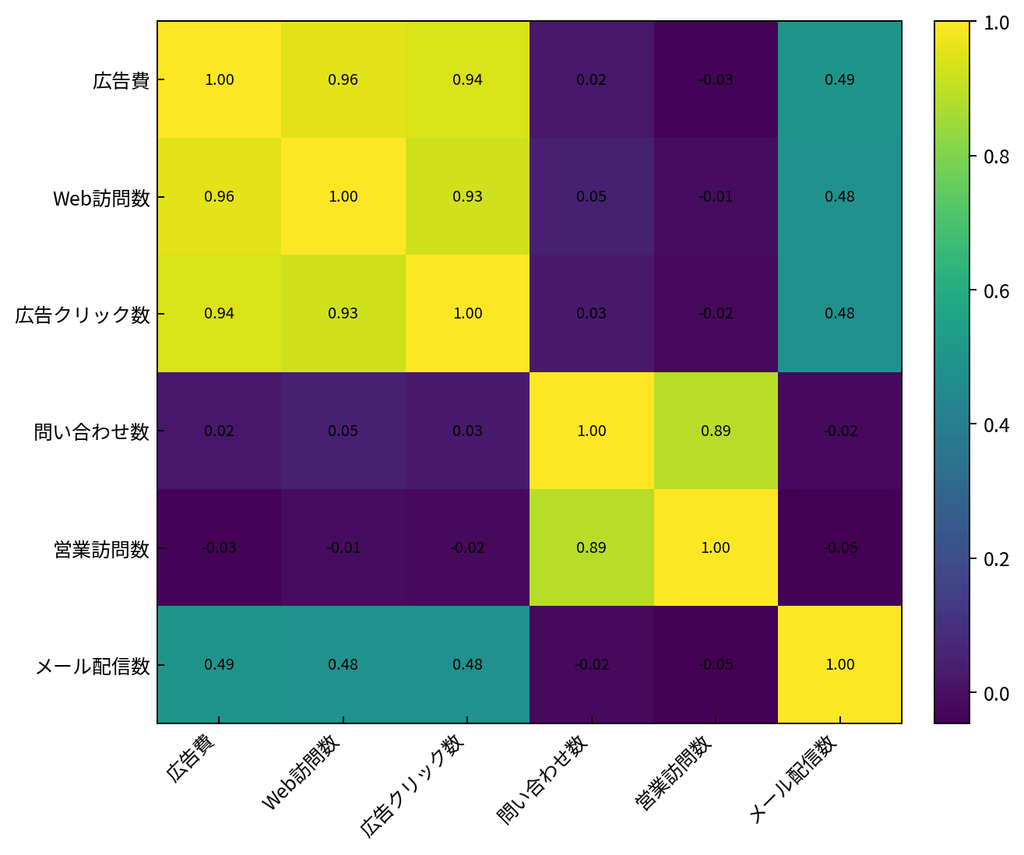
例えば、広告費が増えるとWeb訪問数や広告クリック数も増える企業では、これらの変数は似た情報を持ちます。また、営業訪問数と問い合わせ数が連動するケースも考えられます。こうしたデータでは「どの変数が売上に効いたか」という係数の解釈が不安定になりやすく、予測精度だけを見てもモデルの違いを理解しにくいことがあります。
広告関連の変数や営業関連の変数に意図的な相関を持たせています。
Ridge・Lasso・Elastic Netを同じ架空データで比較する
比較用の疑似データ
ここからは、320件の架空データを使って3手法を比較します。目的変数は「月間売上」、説明変数は広告費、Web訪問数、広告クリック数、問い合わせ数、営業訪問数、メール配信数、キャンペーン回数、割引率、季節指数、ノイズ変数の10項目です。実在企業のデータではなく、モデルの挙動を説明するために生成したサンプルです。
学習用75%、テスト用25%に分割し、説明変数はStandardScalerで標準化しました。RidgeとLassoではalpha、Elastic Netではalphaとl1_ratioを5分割交差検証で探索しています。実装にはPythonとscikit-learnを使用しています(Pedregosa et al., 2011)。再現用のデータとJupyter Notebookは記事付属ファイルとして用意できます。
MAEを比較する
テストデータに対するMAEは、Ridgeが1.986、Lassoが1.980、Elastic Netが1.979でした。今回のサンプルでは3手法の差は非常に小さく、MAEだけを根拠に「どれが優れている」と判断できるほどの違いではありません。
今回の架空データでは3手法の予測誤差は近い結果になりました。
この結果は実務上重要です。モデル比較では、数値が最小だったモデルを自動的に採用するのではなく、「差が実務上意味のある大きさか」「データ分割を変えても傾向が維持されるか」「説明しやすさや運用負荷に違いがあるか」を確認する必要があります。
非ゼロ係数となった特徴量数を比較する
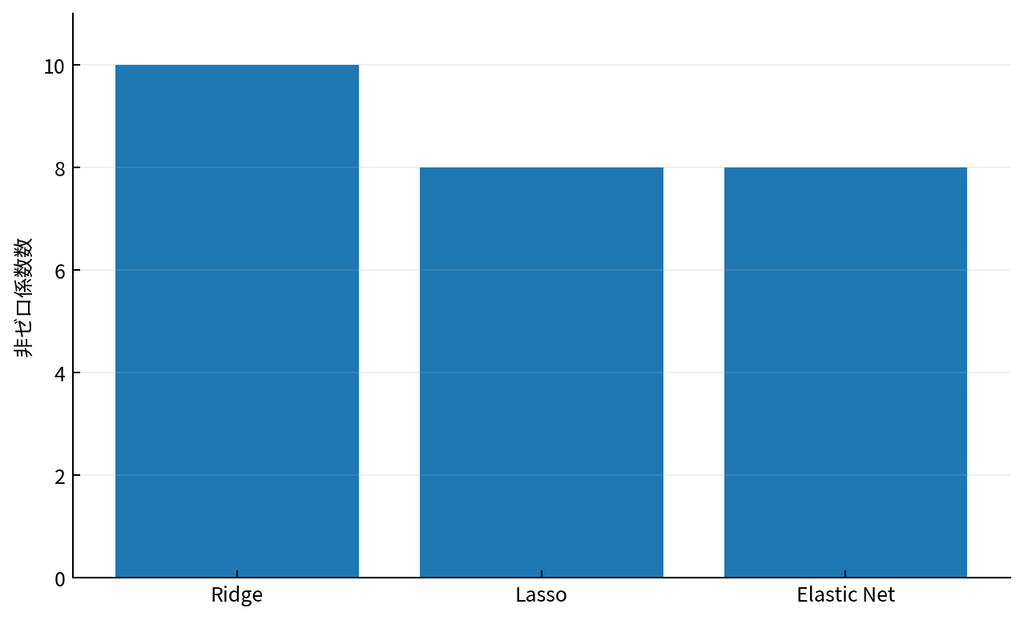
次に、係数が0ではなかった説明変数の数を比較します。Ridgeは10個、Lassoは8個、Elastic Netは8個でした。Ridgeは10変数すべてを残した一方、LassoとElastic Netでは2変数の係数が0になっています。
ここでの「非ゼロ係数数」は、業務上重要な変数の数を意味するものではありません。
「選択特徴量数」という表現はLassoやElastic Netでは直感的ですが、Ridgeは通常、係数を完全な0にすることを目的としません。そのため本記事では3手法を同じ言葉で比較するため、非ゼロ係数となった特徴量数と表現しています。
標準化後の係数を比較する
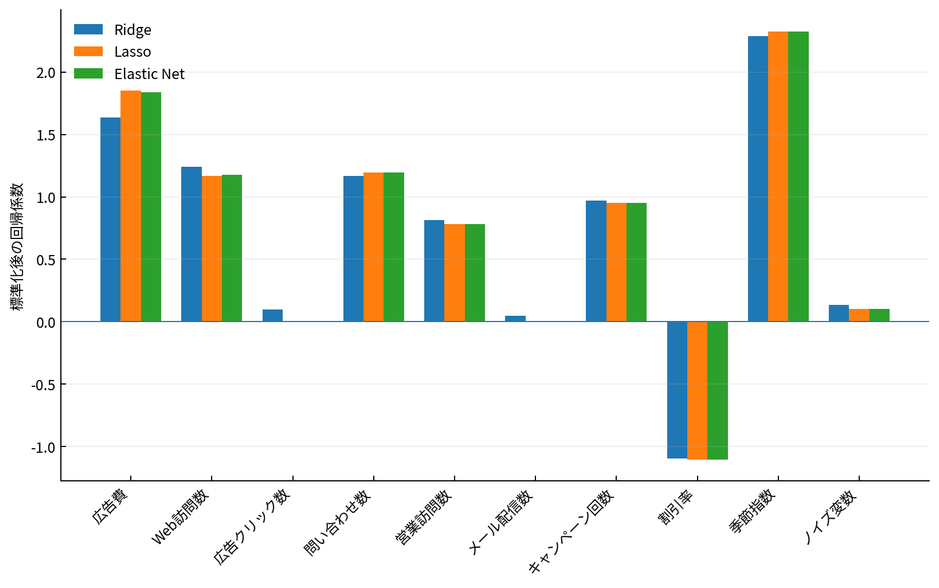
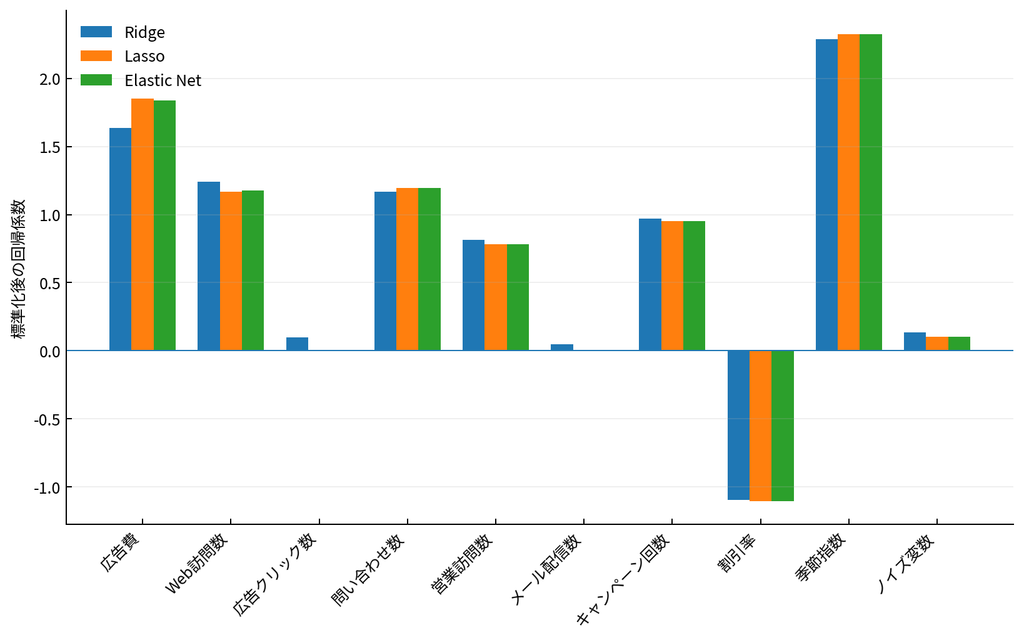
3手法の違いをさらに見るには、標準化後の回帰係数を確認します。今回のデータでは、広告費やWeb訪問数、問い合わせ数、営業訪問数、割引率、季節指数などに係数が残る一方、LassoとElastic Netでは広告クリック数とメール配信数の係数が0になりました。これらは広告費やWeb訪問数と相関を持つように生成した変数です。
係数の絶対値は、標準化した説明変数に対するモデル内の重みであり、因果効果を示すものではありません。
この図から分かるのは、予測誤差が近くても、モデル内部で説明変数をどのように扱っているかは同じではないということです。業務でモデルを説明したり、将来的に取得するデータ項目を整理したりする場合には、MAEだけでなく係数の構造も確認する価値があります。
比較結果をどう解釈するか
MAEだけではモデルを決められない
今回の比較ではElastic NetのMAEがわずかに小さくなりましたが、差はごく小さいものでした。この程度の差を見て「Elastic Netが最良」と結論づけるのは適切ではありません。異なる乱数、異なるデータ分割、異なる期間で評価すれば順位が変わる可能性があります。
実務では、平均的な予測誤差だけでなく、大きく外したケース、予測値を使う意思決定のコスト、再学習頻度、説明責任なども評価対象になります。例えば、売上予測の誤差が1単位改善しても業務判断が変わらないのであれば、より説明しやすいモデルを選ぶ方が合理的な場合もあります。
特徴量数が少なければよいわけではない
LassoやElastic Netで説明変数が減ることは、モデルを簡潔にする点では利点になり得ます。しかし、係数が0になったことと、取得を止めてよいデータ項目であることは別問題です。将来のデータ分布が変化した場合、その変数が再び有用になる可能性もあります。
さらに、説明変数同士が強く相関していると、似た情報を持つ複数の変数のうちどれに係数が割り当てられるかが変わる場合があります。そのため「残った変数だけが重要」と単純化せず、業務知識と合わせて解釈する必要があります。
Elastic Netが向いている可能性があるケース
- 説明変数が多く、ある程度絞り込みたい
- 互いに相関する説明変数のグループが存在する
- Lassoでは変数が落ちすぎる、または選択が不安定に見える
- RidgeのようなL2正則化の性質も取り込みたい
- 交差検証でalphaとl1_ratioを比較できるデータ量と評価設計がある
RidgeやLassoを選んだ方がよいケース
Elastic Netには調整できる自由度がありますが、その分だけ評価する組み合わせも増えます。説明変数を広く残したい目的が明確ならRidge、疎な線形モデルを作ることが目的でLassoの挙動が安定しているならLassoが分かりやすい場合があります。モデルは複雑であるほど良いわけではなく、目的に対して必要な複雑さを選ぶことが重要です。
Elastic Netを実務で使う際の注意点
説明変数は原則としてスケールをそろえる
Ridge・Lasso・Elastic Netでは係数の大きさに対してペナルティを与えるため、説明変数の単位が大きく異なる場合には注意が必要です。例えば広告費が100万円単位、クリック率が0〜1、訪問数が数千件という状態をそのまま扱うと、ペナルティの影響を比較しにくくなります。本記事ではStandardScalerを用いて学習データ内で標準化し、その前処理とモデルをPipelineとしてまとめています。
alphaとl1_ratioは検証データで選ぶ
alphaを大きくすれば正則化は強くなりますが、大きければよいわけではありません。強すぎる正則化は必要な信号まで縮小し、予測性能を低下させる可能性があります。Elastic Netではさらにl1_ratioが加わるため、候補値を交差検証で比較します。scikit-learnにはElasticNetCVも用意されており、複数のl1_ratioとalphaを検証できます。
選択された変数を因果関係と解釈しない
回帰係数はモデル内の関係を表しますが、それだけで「この施策を増やせば売上がこの分だけ増える」と因果的に解釈することはできません。交絡要因、データ収集の偏り、施策実施のルールなどが影響している可能性があります。予測モデルと施策効果の推定は目的が異なるため、意思決定に使うときは分析設計を分けて考える必要があります。
時系列データでは評価方法を変える必要がある
本記事では手法の違いを分かりやすく比較するため、架空の観測データをランダムに学習用・テスト用へ分割しました。しかし、実際の月次売上や需要予測のように時間順序を持つデータでは、未来の情報が過去の学習に混ざらないように分割する必要があります。時系列データでランダム分割をそのまま使うと、実運用時より良い評価値が出る可能性があります。
実務では「どのモデルか」より先に分析設計を確認する
Ridge・Lasso・Elastic Netの比較は重要ですが、実務ではモデルを選ぶ前に確認すべきことがあります。目的変数が本当に業務課題を表しているか、説明変数が予測時点で利用できるか、欠損や集計粒度に問題がないか、評価指標が意思決定と対応しているか、といった設計です。
例えば「売上を予測したい」という要望でも、在庫計画に使うのか、営業人員を配置するのか、予算を配分するのかで、必要な予測単位や許容できる誤差は変わります。分析の目的が曖昧なままモデルだけを高度化すると、精度は改善しても業務で使われない結果になり得ます。
SCI総合研究所株式会社のRASHINRAでは、データ活用の目的整理、利用可能なデータの確認、分析方法の比較、結果の解釈、意思決定へのつなげ方までを対象にしています。自社データでRidge・Lasso・Elastic Netのどれを使うべきかという相談も、単にモデル名を決めるのではなく、何を判断するための分析なのかから整理することが重要です。
なお、実データでは欠損値、外れ値、カテゴリ変数、集計期間のずれ、将来時点で取得できない説明変数なども結果に影響します。正則化手法を比較する前に、どの時点で何のデータが利用可能なのかを整理し、学習時と運用時の条件をそろえることが重要です。モデル選択を前処理やデータ設計から切り離さず、一連の分析プロセスとして評価すると、実務で使いやすい結果につながります。
まとめ:Elastic Netも含めて目的とデータからモデルを選ぶ
Elastic Netは、LassoのL1正則化とRidgeのL2正則化を組み合わせた回帰モデルです。変数をある程度絞りながらL2正則化の性質も取り込みたい場合や、相関する説明変数が複数ある場合に検討する価値があります。
- RidgeはL2正則化で係数を縮小し、通常は変数を広く残す
- LassoはL1正則化で一部の係数を0にし得る
- Elastic NetはL1とL2を組み合わせ、l1_ratioで配分を調整する
- MAEだけでなく、係数や非ゼロ係数数も確認する
- 係数が0であることと、業務上不要であることは同じではない
- 実務では分析目的、データ品質、評価方法、運用方法まで含めてモデルを選ぶ
今回の架空データでは、Ridge・Lasso・Elastic NetのMAE差は小さく、モデルの優劣を単純に決められる結果ではありませんでした。一方で、係数が残る変数の数や係数の配分には違いがありました。こうした違いを確認することが、モデルを「動かす」だけでなく、業務で使うための分析につながります。
線形回帰から正則化の考え方を整理したい方は、SCI-Naviの「線形回帰とは?単回帰・重回帰で解けるビジネス課題とPython実装例」および「Ridge回帰とLasso回帰とは?正則化の基礎・ビジネス活用例・Python実装を解説」もあわせてご覧ください。
参考文献
- Hoerl, A. E. and Kennard, R. W. 1970. Ridge Regression: Biased Estimation for Nonorthogonal Problems. Technometrics. Vol. 12. Issue 1. pp. 55-67. https://doi.org/10.1080/00401706.1970.10488634
- Tibshirani, R. 1996. Regression Shrinkage and Selection Via the Lasso. Journal of the Royal Statistical Society: Series B (Methodological). Vol. 58. Issue 1. pp. 267-288. https://doi.org/10.1111/j.2517-6161.1996.tb02080.x
- Zou, H. and Hastie, T. 2005. Regularization and Variable Selection Via the Elastic Net. Journal of the Royal Statistical Society Series B: Statistical Methodology. Vol. 67. Issue 2. pp. 301-320. https://doi.org/10.1111/j.1467-9868.2005.00503.x
- Pedregosa et al. 2011. Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research. Vol. 12. No. 85. pp. 2825-2830. https://www.jmlr.org/papers/v12/pedregosa11a.html