
営業・顧客データを分析しようとすると、業種、地域、商品カテゴリ、顧客規模、流入経路など、文字列で管理されている項目が数多く登場します。こうしたカテゴリ変数は、数値だけを前提とする多くの機械学習アルゴリズムでは、そのままでは扱いにくいデータです。
CatBoostは、このようなカテゴリ変数を扱う仕組みを備えた勾配ブースティングのライブラリです。Pythonでは、カテゴリ列をcat_featuresとして指定することで、業種や地域などを手作業ですべてOne-Hot Encodingしてから学習する必要性を下げられます。CatBoostはカテゴリ特徴を内部で数値特徴へ変換しながら学習を進めます。
ただし、「CatBoostなら前処理が不要」「文字列を入れれば自動的に良い予測ができる」という意味ではありません。予測時点で使えるデータだけを選ぶこと、目的変数の情報漏洩を防ぐこと、評価期間を適切に分けること、予測確率を営業判断へどうつなげるかを考えることは、モデル選択以上に重要です。
この記事では、実在企業とは無関係の架空BtoB商談データ6,000件を作成し、受注=1、失注=0の二値分類としてCatBoostClassifierを学習します。業種、地域、商品カテゴリなどのカテゴリ変数を直接指定し、ROC-AUC、Logloss、Precision、Recall、予測受注確率帯ごとの実受注率を確認します。
CatBoostとは
CatBoostは勾配ブースティングの一種
CatBoostは、複数の決定木を逐次的に追加して損失を小さくしていく勾配ブースティング系の機械学習ライブラリです。CatBoostの原論文では、従来の勾配ブースティングやカテゴリ変数の目的変数ベース変換で起こり得るprediction shiftやtarget leakageの問題を整理し、順序付けを利用する方法を提案しています(Prokhorenkova et al., 2018)。
今回扱うCatBoostClassifierは分類問題向けの実装です。例えば、受注/失注、解約/継続、不良/正常など、ラベルを分類したい場合に利用できます。一方、売上金額や需要量など連続値を予測したい場合にはCatBoostRegressorが候補になります。
「Cat」はCategorical Featuresに由来する
CatBoostという名称は「Categorical Boosting」に由来します。大きな特徴の一つが、数値変数とカテゴリ変数を同じデータセット内で扱えることです。公式ドキュメントでは、カテゴリ特徴を事前に全面的なOne-Hot Encodingへ変換してから渡すことは推奨されていません。
例えば、pandas DataFrameに「業種」「地域」「商品カテゴリ」という文字列列が含まれている場合、それらの列名をcat_featuresへ指定できます。分析者が業種ごとに数十列のダミー変数を手作業で作る必要性を下げられる点は、カテゴリ項目の多い営業・顧客データで扱いやすいポイントです。
CatBoostがカテゴリ変数を扱いやすい理由
CatBoostはカテゴリ特徴を、そのまま文字列として木の分岐条件に使うわけではありません。木の分割を選ぶ前に、カテゴリ特徴やその組み合わせから統計量を計算し、数値特徴へ変換して利用します。低カーディナリティのカテゴリについては、条件に応じて内部でOne-Hot Encodingが利用される場合もあります。
したがって、「CatBoostではOne-Hot Encodingという処理が存在しない」という理解は正確ではありません。より実務的には、分析者がすべてのカテゴリ特徴を事前にOne-Hot Encodingする必要性を下げられると捉えるとよいでしょう。
カテゴリ変数はなぜ機械学習で問題になるのか
業種・地域・商品カテゴリはそのまま数値ではない
例えば「製造業」「小売業」「情報通信業」という業種に対して、製造業=1、小売業=2、情報通信業=3と単純な整数を割り当てると、数値上は情報通信業が製造業の3倍であるかのような不要な順序関係を持ち込みます。カテゴリのラベルと数量的な大小関係は別物です。
| 種類 | 今回の例 | モデルでの扱い |
|---|---|---|
| カテゴリ変数 | 業種、地域、商品カテゴリ、顧客規模、流入経路 | cat_featuresで指定 |
| 数値変数 | 従業員数、案件金額、商談回数、過去取引回数など | 数値として入力 |
| 期間情報 | 商談開始日 | 学習/評価期間の分割に利用 |
| 目的変数 | 受注フラグ | 受注=1、失注=0 |
One-Hot Encodingで列数が増える問題
カテゴリ変数を扱う一般的な方法の一つがOne-Hot Encodingです。例えば地域が7種類なら、地域に対応する複数の0/1列を作ります。カテゴリ数が少なければ分かりやすい方法ですが、業種分類、商品コード、販売チャネルなどカテゴリ数の多い特徴が増えると、生成される列数も増えていきます。
CatBoostを使う場合、カテゴリ列をカテゴリ特徴としてモデルへ渡せます。ただし、これによって「カテゴリ数がどれだけ多くても問題ない」わけではありません。ほぼ一意なID、入力ミスで表記揺れしたカテゴリ、将来予測に利用できないカテゴリなどは、CatBoostであってもデータ設計上の問題として残ります。
目的変数を使ったエンコーディングと情報漏洩
カテゴリごとの平均受注率を計算し、その値を特徴量として使う方法を考えてみます。製造業の受注率が60%なら「製造業=0.60」のように変換できます。しかし、その行自身の受注/失注ラベルを含めて平均を作ると、説明変数側へ目的変数の情報が入り込みます。これがtarget leakageの一例です。
CatBoostの原論文では、この問題に対してランダムな順序を導入し、ある学習サンプルのカテゴリ統計を計算するとき、そのサンプルより前に位置するデータを利用する考え方が示されています(Prokhorenkova et al., 2018)。
CatBoostはカテゴリ変数をどう処理するのか
cat_featuresでカテゴリ列を指定する
Pythonでは、カテゴリ列のインデックスまたは列名をcat_featuresへ渡せます。pandas DataFrameを使う場合、列名をそのまま指定するとコードの意味が読みやすくなります。
from catboost import CatBoostClassifiercat_features = ["業種", "地域", "商品カテゴリ", "顧客規模", "流入経路"]model = CatBoostClassifier( iterations=450, learning_rate=0.05, depth=6, loss_function="Logloss", eval_metric="AUC", random_seed=42, verbose=False,)model.fit( X_train, y_train, cat_features=cat_features, eval_set=(X_test, y_test), early_stopping_rounds=50,)win_probability = model.predict_proba(X_test)[:, 1]この例では、業種や地域をあらかじめ整数へ変換していません。数値変数は数値のまま、カテゴリ変数は文字列のまま保持し、CatBoostへどの列がカテゴリ特徴なのかを伝えています。
カテゴリ特徴から統計量を作る
CatBoostはカテゴリ特徴やカテゴリ特徴の組み合わせから、木の学習に利用できる数値特徴を生成します。カテゴリ数が少ない特徴は内部でOne-Hot Encodingされる場合があり、それ以外ではCtrと呼ばれる統計量が利用されます。どの処理が使われるかは学習条件やパラメータによって異なります。
Ordered Target Statisticsの考え方
カテゴリ別の目的変数統計を作る際に重要なのは、「予測したい行自身の正解情報を使わない」ことです。CatBoostでは順序付けを利用し、対象サンプルより前のデータから統計を計算することで、単純なtarget statisticsで起こり得る情報漏洩と学習/推論時の分布差を抑える設計が採用されています(Prokhorenkova et al., 2018)。
この図は理解のための概念化であり、実際のCatBoost内部処理をすべて表現したものではありません。カテゴリ特徴の組み合わせ、複数のCtr、木構築など、実装にはさらに多くの処理があります。
Ordered Boostingとの違いに注意する
ここで混同しやすいのが、カテゴリ特徴の順序付き統計とOrdered Boostingです。どちらもCatBoostの原論文で重要な順序付けの考え方ですが、同じものではありません。Ordered Boostingは勾配ブースティング自体で生じるprediction shiftへの対策として提案された学習方式です。
現行のCatBoostにはPlainとOrderedというboosting_typeが存在し、常にOrderedが使われるわけではありません。したがって、「CatBoostを使えば必ずOrdered Boostingになる」と説明するのは避ける必要があります。
受注予測データでCatBoostを試す
今回使用する人工営業データ
今回のサンプルでは6,000件の人工BtoB商談データを生成しました。実在企業や実顧客のデータは使用していません。1行を1商談とし、カテゴリ変数は業種、地域、商品カテゴリ、顧客規模、流入経路の5項目、数値変数は従業員数、想定案件金額、商談回数、初回接触からの日数、過去取引回数、Web閲覧回数、資料ダウンロード数の7項目です。
人工データには、例えば「製造業×設備」「情報通信業×ソフトウェア」など一部のカテゴリ組み合わせで受注確率が変わるような関係を入れています。また、既存顧客や紹介、商談回数、過去取引回数などにも人工的な関係を設定しています。これらはCatBoostの挙動を説明するための生成ルールであり、現実の営業活動における受注要因を示すものではありません。
学習期間と評価期間を分ける
営業予測では、過去の案件から将来案件を予測する使い方が一般的です。そのため今回はランダム分割ではなく、2024年1月〜2026年3月の5,053件を学習し、2026年4月〜9月の947件を評価しました。学習期間の受注率は38.4%、評価期間は41.1%です。
この期間分割により、将来期間の正解ラベルを学習へ混ぜずに評価できます。ただし、実案件では季節性、市況変化、営業組織変更、商品改定なども起こるため、期間分割だけで十分とは限りません。
CatBoostClassifierを学習する
CatBoostClassifierは最大450回の反復を設定し、学習率0.05、木の深さ6としました。評価データのAUCが改善しなくなった場合に学習を止めるearly stoppingを設定しています。今回の実行ではbest iterationは152でした。
ハイパーパラメータは説明用の一般的な設定であり、SCI総研独自の選定ロジックではありません。実データでは目的、データ量、不均衡度、計算資源などに応じて検証する必要があります。
受注確率を予測する
predict_probaを使うと、単に受注/失注を0・1で返すのではなく、各商談について受注クラスへ属する予測確率を取得できます。例えば0.72なら、モデル上は受注側へ比較的強く分類されていることを表します。
ただし、予測確率72%という値を「この案件は72%の確率で必ず受注する」と個別案件に対して断定的に読むのは避けます。確率予測は集団としての較正や再現性も確認し、意思決定へ使う際には案件金額や営業コストなど別の条件も考える必要があります。
モデルをどう評価するか
Accuracyだけでは判断しない
今回の評価期間ではAccuracyは0.693でした。しかし、分類問題ではAccuracyだけを見ると判断を誤ることがあります。例えば受注率が20%しかないデータなら、すべて失注と予測するだけでAccuracy 80%になります。
そこで本記事では、クラスの識別順位を見るROC-AUC、確率予測の損失を見るLogloss、受注と判定した案件のうち実際に受注した割合に関係するPrecision、実受注案件をどれだけ拾えたかに関係するRecallを確認します。
| 評価指標 | 今回の結果 | 見るポイント |
|---|---|---|
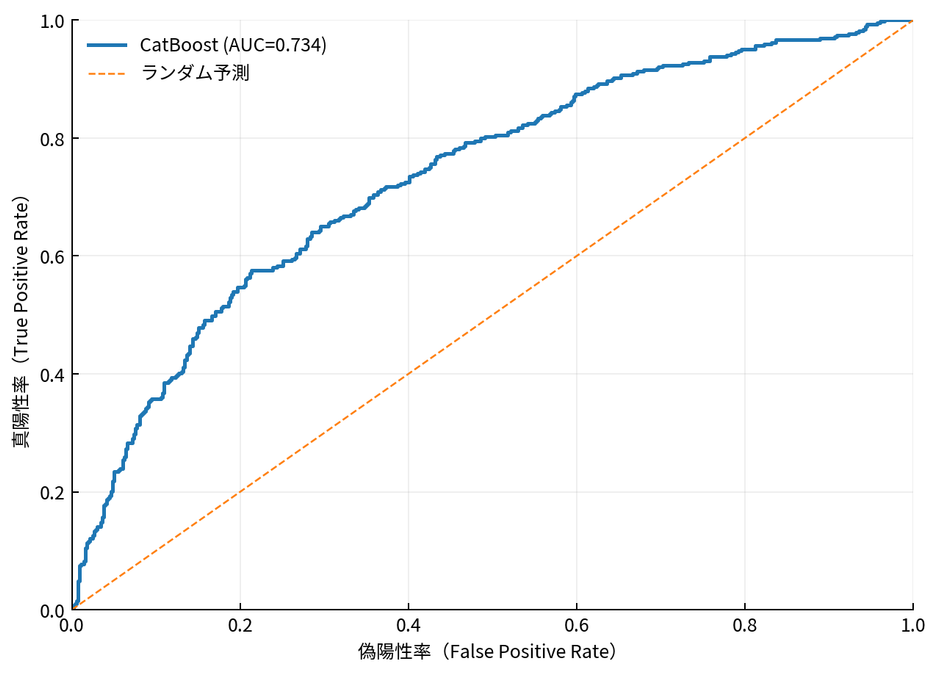
| ROC-AUC | 0.734 | 受注案件を失注案件より高く順位付けできる傾向 |
| Logloss | 0.596 | 確率予測の誤差。小さいほどよい |
| Precision | 0.687 | 0.5以上を受注とした場合の適合率 |
| Recall | 0.463 | 実受注案件を拾えた割合 |
| Accuracy | 0.693 | 全体の正解率 |
ROC-AUCを見る
今回の人工データではROC-AUCは0.734でした。0.5はランダムな順位付けに相当し、1に近いほど受注案件を失注案件より上位へ配置しやすいことを示します。今回のモデルは人工データ上で一定の識別情報を捉えていますが、実務データでも同程度の性能が得られることを意味しません。
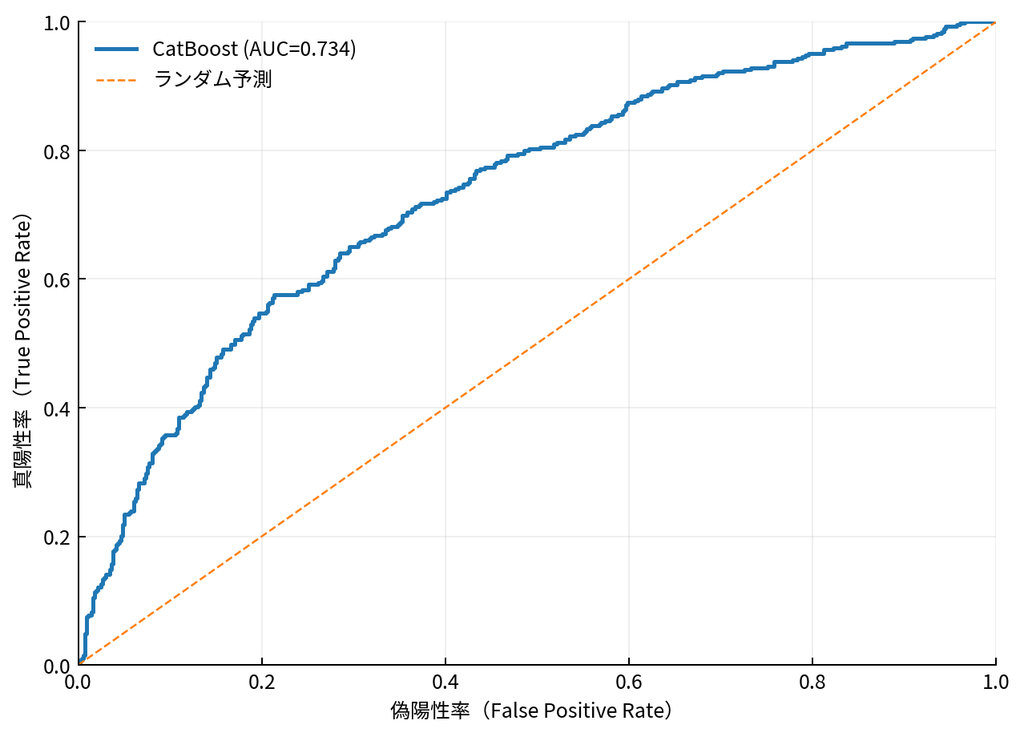
AUC=0.734。
PrecisionとRecallを見る
予測確率0.5を仮の判定しきい値とした場合、Precisionは0.687、Recallは0.463でした。営業活動では、PrecisionとRecallのどちらを重視するかでしきい値の考え方が変わります。
限られた営業工数で確度の高い案件に絞るならPrecisionを重視する考え方があります。一方、受注可能性のある案件をなるべく見逃したくないならRecallの重要性が上がります。0.5というしきい値自体に業務上の必然性はありません。
Loglossで確率予測を見る
今回のLoglossは0.596でした。Loglossは、正解したかどうかだけでなく予測確率の自信度も評価します。実際には失注した案件へ0.99の受注確率を付けたような「自信を持った誤予測」に大きなペナルティが入ります。
予測確率帯ごとの実受注率を見る
営業担当者へモデル結果を返す場合、AUCだけでは直感的に理解しにくいことがあります。そこで、予測受注確率を20%幅に分け、評価期間の実受注率を確認しました。
| 予測受注確率帯 | 案件数 | 実受注率 | 平均予測確率 |
|---|---|---|---|
| 0–20% | 167 | 16.8% | 16.4% |
| 20–40% | 422 | 32.2% | 27.8% |
| 40–60% | 157 | 53.5% | 48.8% |
| 60–80% | 182 | 69.2% | 69.3% |
| 80–100% | 19 | 78.9% | 83.7% |
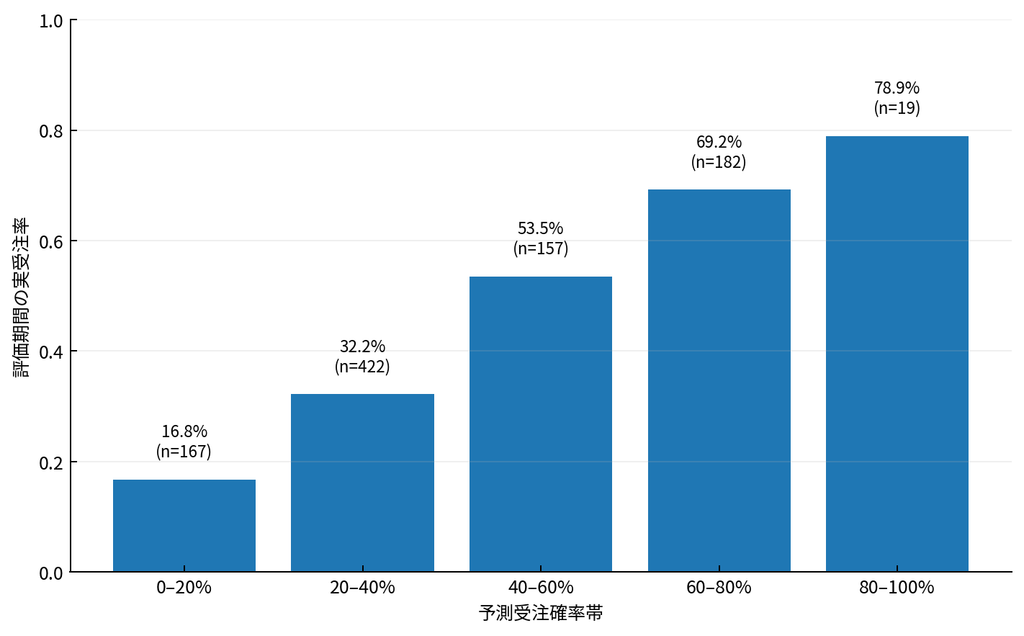
確率帯が高いほど実受注率も高くなる傾向が確認できます。ただし各帯の件数が異なるため、少数帯の数値は不確実性が大きい点に注意が必要です。
カテゴリ変数が多いデータでCatBoostを使うメリット
前処理を簡潔にしやすい
業種や地域などをカテゴリ特徴として明示できるため、分析者が大量のダミー変数を生成し、その列構成を学習時と推論時でそろえる処理を減らしやすくなります。これはモデル精度だけでなく、分析コードの見通しや再現性にも関係します。
カテゴリ数が多い項目を扱いやすい
カテゴリ数が多い変数でも、全面的なOne-Hot Encodingに限定せず扱える点はCatBoostの特徴です。ただし、高カーディナリティであれば何でも投入すべきではありません。顧客IDや案件IDのようにほぼ一意な識別子は、過去データを覚える方向へ働き、将来案件へ一般化しない可能性があります。
数値変数とカテゴリ変数を同じモデルで扱える
営業データには、業種のようなカテゴリ変数と、案件金額や商談回数のような数値変数が混在します。CatBoostではこれらを同じモデルへ入力できるため、営業・顧客分析の表形式データと構造的に相性のよい場面があります。
CatBoostを使う際の注意点
顧客IDや案件IDをそのまま入れない
CatBoostが高カーディナリティのカテゴリを扱えるからといって、顧客IDや案件IDをそのまま入れることが適切とは限りません。IDは識別のための値であり、新規顧客や新規案件では過去と同じ値が現れない場合があります。特徴量にするなら、そのID自体ではなく「過去取引回数」など予測時点で意味を持つ情報へ変換する方が実務的な場合があります。
未来の情報を説明変数へ混ぜない
受注予測で最も注意したいのが時間的な情報漏洩です。例えば受注後に確定する最終値引率、契約締結までの日数、最終商談回数を「商談初期の受注予測」に使えば、評価値は高く見えても実運用では利用できません。
どの特徴量が使えるかは、「いつ予測するか」を先に決めてから判断します。今回の人工データでも、商談評価時点で取得済みという前提の変数だけをモデルへ入れています。
学習期間と評価期間を分ける
営業活動では商品構成、市況、営業体制、顧客ニーズが時間とともに変化します。ランダムにデータを混ぜて学習・評価すると、未来の予測という実運用条件より評価が楽になることがあります。可能であれば、過去期間で学習し、それより新しい期間で評価する方法を検討します。
欠損値とカテゴリ欠損は別に考える
CatBoostは数値特徴の欠損値を扱う機能を持ちますが、カテゴリ特徴の欠損を「意味のあるカテゴリ」としてどう定義するかはデータ設計の問題です。例えば地域が未入力の場合、「不明」というカテゴリを明示するのか、入力ミスとして補正するのかで意味が変わります。欠損処理をモデルへ丸投げせず、業務上の意味を確認する必要があります。
特徴量重要度を因果関係と解釈しない
今回のCatBoostモデルでは、特徴量重要度の上位に流入経路、商談回数、商品カテゴリ、過去取引回数、業種が並びました。しかし、この順位は人工データの生成規則とモデルの学習結果に依存します。「流入経路を変えれば受注率が必ず上がる」といった因果効果を意味するものではありません。
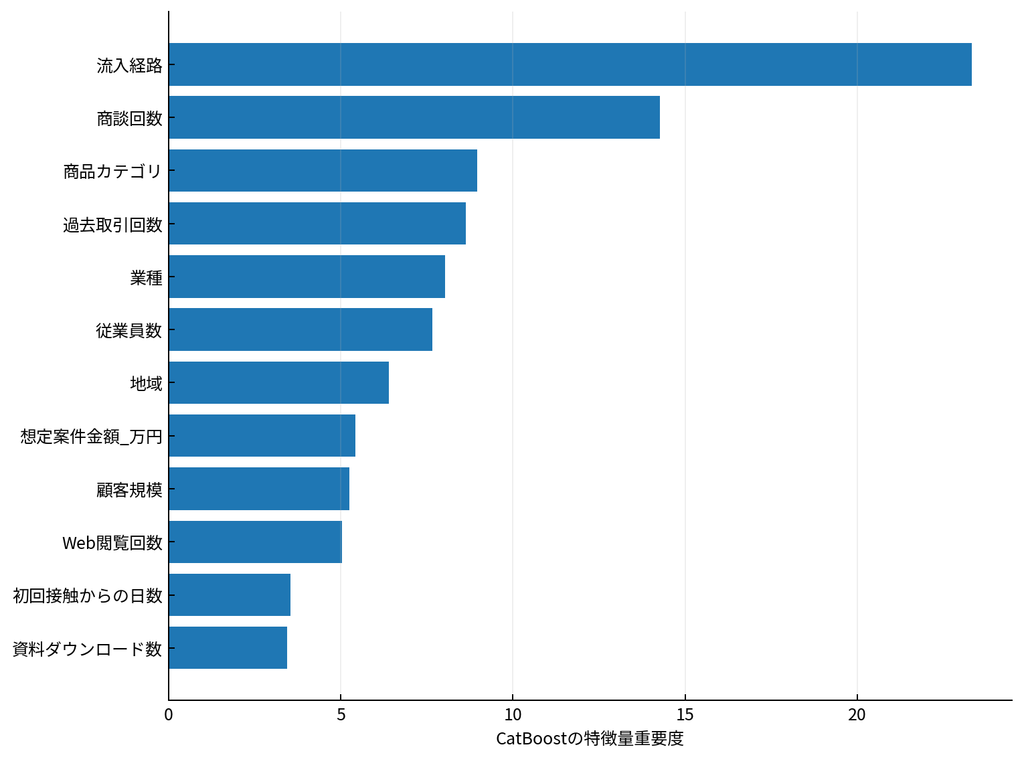
モデルが予測に利用した特徴量の参考値であり、受注の因果要因を示すものではありません。
受注確率を営業判断へどう使うか
確率の高い案件だけを見るのでは不十分
CatBoostで受注確率を出せても、「確率が高い順に営業すればよい」とは限りません。例えば受注確率80%・案件額10万円の案件と、受注確率50%・案件額1,000万円の案件があれば、どちらを優先するかは営業工数、粗利、戦略的重要性、既存顧客との関係などで変わります。
つまり、予測モデルが答えるのは「受注しそうか」という一部分です。実際の営業優先順位は、案件価値や対応コストなどを別途組み合わせた意思決定問題として考える必要があります。
営業コストと案件価値も考える
モデル精度と業務成果を分けて評価する
ROC-AUCが改善したことと、売上や営業生産性が改善したことも同じではありません。モデル導入後は、営業担当者が予測結果を利用できたか、優先順位の変更によって商談化率や受注率がどう変わったか、特定の顧客群を取りこぼしていないかなど、業務指標を別に確認する必要があります。
実務では「CatBoostを使うか」より分析設計が先にある
CatBoostはカテゴリ変数の多い表形式データに対して有力な候補ですが、モデルを選ぶだけでは受注予測は完成しません。予測対象を「今期中の受注」とするのか「30日以内の受注」とするのか、どの時点でスコアを出すのか、失注理由をどう扱うのかによって学習データそのものが変わります。
また、予測対象と営業アクションを混同しないことも重要です。受注確率の予測モデルを作るだけなら機械学習の問題ですが、「限られた営業工数をどの案件へ配分するか」まで進むと、案件価値や制約条件を含む意思決定設計になります。
SCI総合研究所株式会社のRASHINRAでは、営業・顧客・売上・マーケティングデータなどについて、分析目的の整理、データ設計、モデル比較、結果の解釈、意思決定へのつなげ方までを対象にしています。CatBoostを使うこと自体を目的にせず、自社データから何を判断したいのかを起点に整理することが重要です。
まとめ:CatBoostはカテゴリ変数の多い表形式データで有力な候補
- CatBoostはカテゴリ特徴を扱う仕組みを備えた勾配ブースティングである
- pandas DataFrameではカテゴリ列をcat_featuresとして指定できる
- すべてのカテゴリ列を事前にOne-Hot Encodingする必要性を下げられる
- カテゴリ統計では順序付けを利用し、target leakageを抑える工夫がある
- カテゴリ特徴のOrdered Target StatisticsとOrdered Boostingは同じものではない
- 受注予測ではAccuracyだけでなくROC-AUC、Logloss、Precision、Recallなどを確認する
- 予測確率を営業優先順位へそのまま置き換えず、案件価値や営業コストも合わせて判断する
今回の人工データでは、2026年4月〜9月の評価期間に対してROC-AUC 0.734、Logloss 0.596という結果になり、予測確率帯が高いほど実受注率も高い傾向が見られました。ただし、これは人工データと今回の設定に対する結果であり、実務データでの性能を示すものではありません。
CatBoostを理解する前段として勾配ブースティング全体を整理したい場合は、SCI-Naviの「勾配ブースティングとバギングの違いとは?理論・メリット・デメリットをビジネス視点で解説」もあわせてご覧ください。
参考文献
- Prokhorenkova et al. 2018. CatBoost: unbiased boosting with categorical features. Advances in Neural Information Processing Systems. Vol. 31. https://papers.nips.cc/paper/7898-catboost-unbiased-boosting-with-categorical-features
- Pedregosa et al. 2011. Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research. Vol. 12. No. 85. pp. 2825-2830. https://www.jmlr.org/papers/v12/pedregosa11a.html