
線形回帰を使っていると、説明変数同士が強く相関しているために係数の符号や大きさが安定しないことがあります。予測値そのものは大きく変わらないのに、学習データを少し変えただけで「どの変数の係数が大きいか」が入れ替わる場合もあります。
こうした状況で候補になる代表的な方法がRidge回帰です。Ridge回帰は通常の線形回帰にL2正則化を加え、係数が過度に大きくなることへペナルティを与えます。元のRidge回帰は、説明変数が直交していない回帰問題に対し、多少のバイアスを受け入れることで推定量の平均二乗誤差を小さくする方法として提案されました(Hoerl and Kennard, 1970)。
この記事では、相関の強い10個の人工特徴量を作り、通常のLinearRegressionとRidgeを同じデータへ適用します。さらにalphaを変えたときの係数変化、交差検証によるalpha選択、100回の再サンプリングによる係数安定性まで確認します。使用するデータはすべて説明用に生成した人工データであり、実在企業や実案件とは関係ありません。
Ridge回帰とは
Ridge回帰は線形回帰にL2正則化を加えたモデル
通常の最小二乗法では、実測値と予測値の差である残差の二乗和を最小にするように回帰係数を求めます。Ridge回帰はこの目的関数に、係数の二乗和を追加します。
||y − Xw||²₂ + α||w||²₂
第1項は通常の線形回帰でも使う残差平方和、第2項がL2正則化です。wは回帰係数、α(alpha)は正則化の強さを調整する値です。scikit-learnのRidgeも、この形の目的関数を最小化する線形回帰として実装されています(Pedregosa et al., 2011)。
通常の線形回帰と何が違うのか
通常の線形回帰は「予測誤差をどれだけ小さくできるか」を中心に係数を求めます。一方、Ridge回帰では「予測誤差を小さくすること」と「係数を過度に大きくしないこと」を同時に考えます。
Ridge回帰は係数へバイアスを導入する代わりに、その分散を小さくすることを狙います。つまり「少し偏っていても、学習データが変わるたびに係数が大きく揺れる状態を避ける」という考え方です。
Ridge回帰が使われる場面
Ridge回帰が候補になりやすいのは、説明変数が多く、似た情報を持つ変数が複数存在する場面です。例えば売上分析では広告表示回数・Web訪問数・資料請求数、設備分析では複数センサー値、営業分析では接触回数・商談回数・提案件数など、互いに相関した指標が同時に存在することがあります。
ただし、Ridgeを使えば説明変数同士の相関そのものがなくなるわけではありません。L2ペナルティによって推定問題の条件を改善し、係数を安定させる方向へ働くと理解する方が正確です。
L2正則化とは
係数の二乗和にペナルティを与える
L2正則化では、各係数を二乗して合計した||w||²₂をペナルティとして使います。係数の絶対値が大きくなるほど二乗値も大きくなるため、予測誤差を小さくするためだけに一部の係数が極端な値になることを抑えます。
一般にRidgeでは、係数は0方向へ縮小しますが、L1正則化を使う手法のように多数の係数を厳密に0へすることを主目的とはしません。そのため、Ridgeを「特徴量選択のための方法」とだけ説明するのは適切ではありません。
alphaは何を調整しているのか
alphaは、残差平方和とL2ペナルティのどちらをどの程度重視するかを調整します。alphaが小さいと通常の線形回帰に近づき、alphaを大きくすると係数の縮小が強くなります。
- alphaが小さい:学習データへの当てはまりを重視し、OLSに近い係数になる。
- alphaが中程度:予測誤差と係数縮小のバランスを取る。
- alphaが非常に大きい:係数を強く0へ縮め、必要な関係まで弱める可能性がある。
したがって、「alphaが大きいほど良い」わけではありません。alphaはデータに合わせて評価するパラメータです。
相関の強い説明変数で何が起こるのか
多重共線性とは
複数の説明変数同士に強い線形関係がある状態は、一般に多重共線性と呼ばれます。例えばX1とX2がほぼ同じ情報を持っていると、目的変数を説明する際に「X1へどれだけ係数を割り当て、X2へどれだけ割り当てるか」を一意に安定して決めにくくなります。
このとき、予測値は大きく変化しなくても、個々の係数は学習データのわずかな違いで大きく変わることがあります。係数を業務上解釈したい場合には、この不安定性が問題になります。
相関の強い10特徴量を持つ人工データを作る
今回は720件の人工データを生成しました。X1〜X4は潜在因子A、X5〜X7は潜在因子B、X8〜X9は潜在因子Cをもとに、それぞれ少量のノイズを加えて作っています。X10は比較的独立した特徴量です。
目的変数はy = 3A − 2B + 1.5C + 0.4X10 + ノイズで生成しました。同じ潜在因子を反映する複数の特徴量を持たせることで、「似た情報を持つ変数が複数ある」という状況を意図的に再現しています。また、特徴量ごとに元の尺度を変え、標準化の必要性も確認できるようにしています。
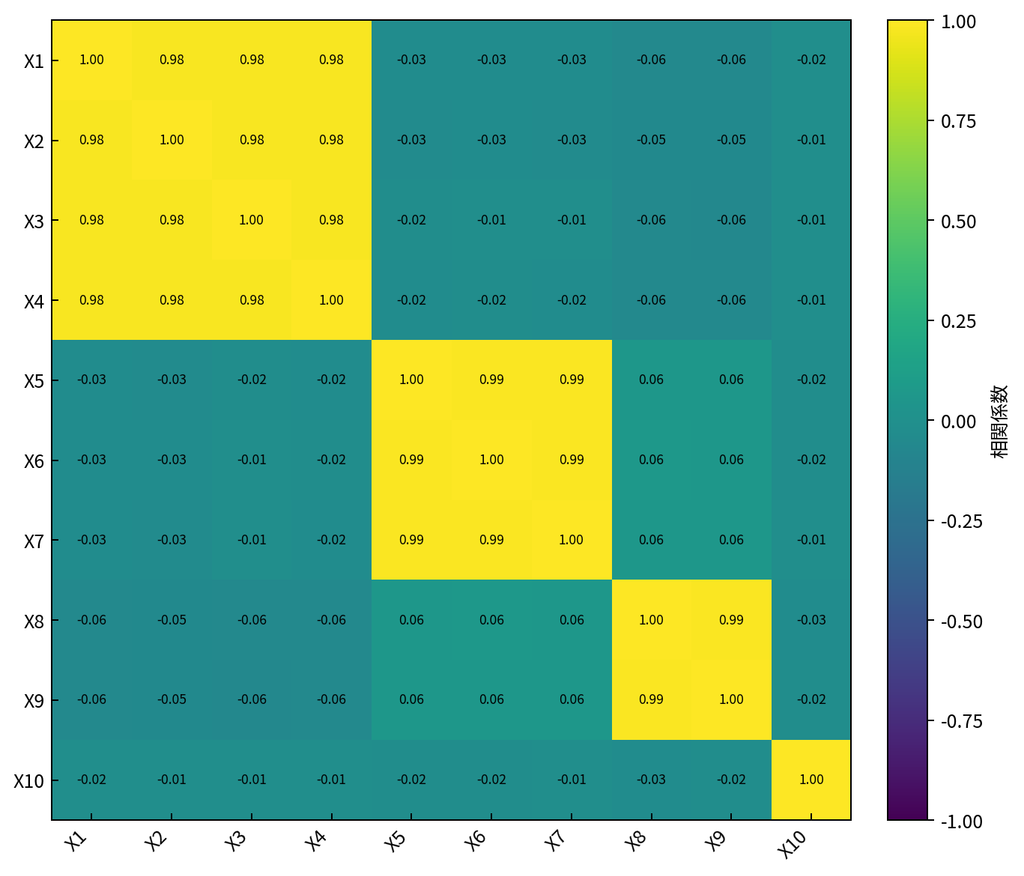
X1〜X4、X5〜X7、X8〜X9の各グループ内に強い相関があるように生成しています。
この相関はRidgeを使っても消えません。Ridgeが変えるのは説明変数そのものではなく、係数を推定するときの目的関数です。
LinearRegressionとRidgeの係数を比較する
StandardScalerを含むPipelineを作る
L2ペナルティは係数の大きさに作用するため、特徴量の尺度が大きく異なると、変数ごとにペナルティの効き方を比較しにくくなります。今回はStandardScalerで各特徴量を平均0・標準偏差1へ標準化してからRidgeを学習します。
from sklearn.pipeline import Pipelinefrom sklearn.preprocessing import StandardScalerfrom sklearn.linear_model import Ridgeridge_model = Pipeline([ ("scaler", StandardScaler()), ("ridge", Ridge(alpha=10.0))])ridge_model.fit(X_train, y_train)pred = ridge_model.predict(X_test)比較条件をそろえるため、通常のLinearRegression側も同じStandardScalerを通しています。これにより、表示する係数は標準化後特徴量に対する係数として比較できます。
通常の線形回帰とRidgeの予測性能
データの75%を学習用、25%をテスト用に分けました。Ridgeのalphaは後述する5分割交差検証で選び、今回の人工データでは10が選択されました。
| モデル | alpha | R² | MAE | RMSE | 係数L2ノルム |
|---|---|---|---|---|---|
| LinearRegression | ― | 0.943 | 0.751 | 0.970 | 2.294 |
| Ridge | 10 | 0.943 | 0.750 | 0.969 | 2.187 |
今回の人工データでは、LinearRegressionのR²が0.943、Ridgeが0.943で、予測性能はほぼ同程度でした。一方、標準化後係数のL2ノルムは2.294から2.187へ小さくなっています。
ここで重要なのは、Ridgeの価値を「R²が上がったかどうか」だけで判断しないことです。今回の差は非常に小さく、人工データだけから「Ridgeの方が高精度」と一般化することはできません。
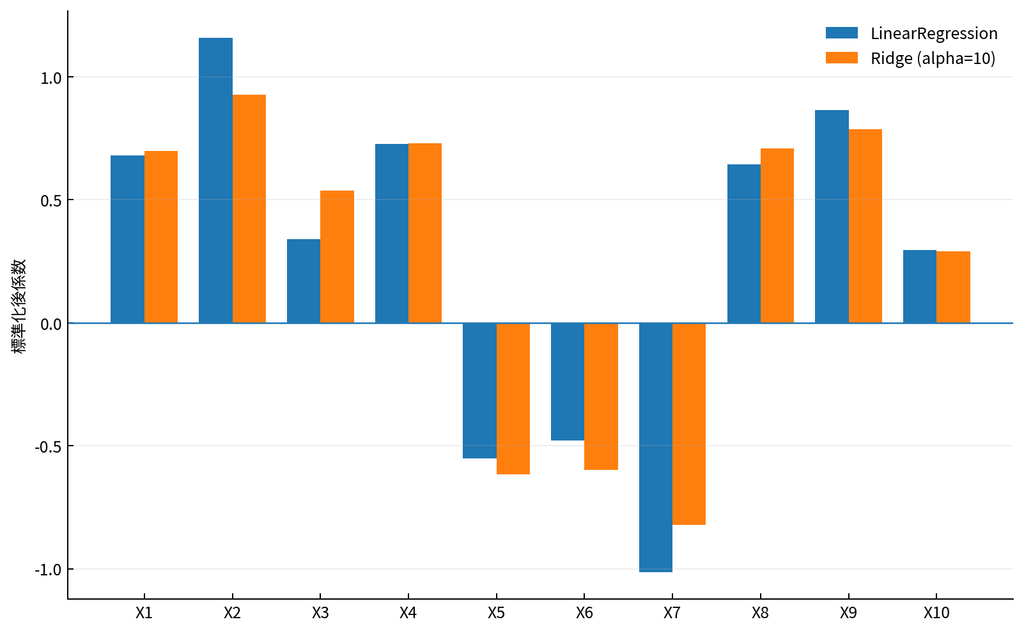
Ridgeでは係数が0方向へ縮小しますが、すべてが0になるわけではありません。
alphaを変えると係数はどう変化するか
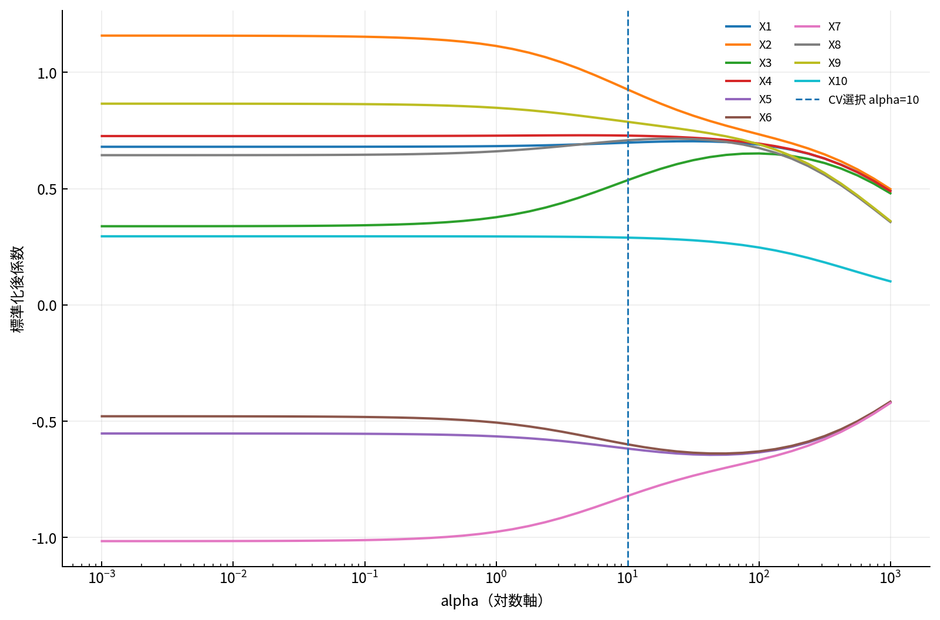
alphaを0.001から1000まで対数スケールで変化させ、各alphaでRidgeを学習しました。
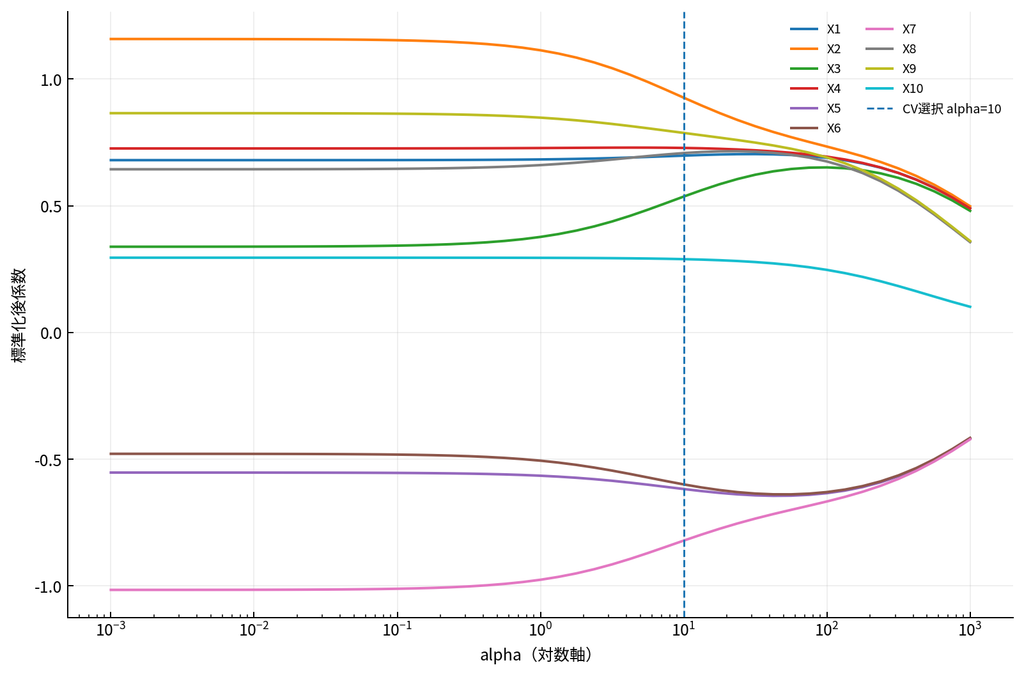
横軸を対数スケールで示しています。alphaが大きくなるにつれて、各係数が徐々に0方向へ縮小する様子を確認できます。破線は今回の交差検証で選択されたalphaです。
このような係数の軌跡はRidge traceやregularization pathとして、正則化強度が係数へ与える影響を理解するために使えます。Ridge回帰の原論文でも、非直交性が係数へ与える影響を把握するためridge traceが提案されています(Hoerl and Kennard, 1970)。
alphaが小さい領域では係数はOLSに近く、大きくなるほど縮小します。しかし、係数を小さくすること自体が目的ではありません。必要な情報まで抑えると予測誤差が増えるため、適切な強さを評価する必要があります。
alphaをどう選ぶか
テストデータだけでalphaを選ばない
alphaを複数試し、テストデータのRMSEが最も小さかった値を採用し、その同じテストデータで最終性能を報告すると、評価にテストデータの情報を使ったことになります。そのため今回は、学習データ内部の5分割交差検証でalphaを選び、最後にテストデータを1回だけ評価しました。
from sklearn.linear_model import RidgeCValphas = np.logspace(-3, 3, 49)ridge_cv = Pipeline([ ("scaler", StandardScaler()), ("ridge", RidgeCV( alphas=alphas, cv=5, scoring="neg_mean_squared_error" ))])ridge_cv.fit(X_train, y_train)best_alpha = ridge_cv.named_steps["ridge"].alpha_今回の候補範囲ではalpha=10が選択されました。ただし、この値は今回の人工データ、標準化方法、候補範囲、交差検証条件に依存します。「Ridgeではalpha=10が正解」という意味ではありません。
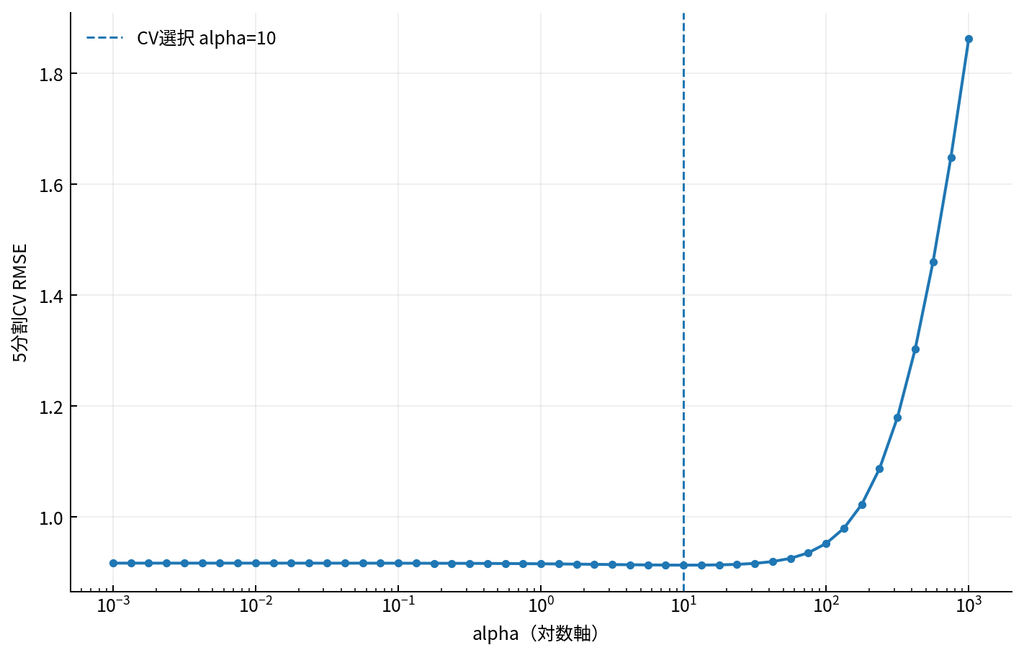
正則化を強くするほど常に誤差が改善するわけではなく、強すぎる正則化では予測に必要な関係まで抑える可能性があります。
Ridge回帰の係数は安定するのか
今回の記事で最も確認したいのが係数の安定性です。学習データ540件のうち80%を毎回ランダムに抽出し、LinearRegressionとRidgeをそれぞれ100回学習しました。各回でStandardScalerも学習し直し、標準化後係数を保存しています。
| 特徴量 | LinearRegression係数 | Ridge係数 | OLS係数SD | Ridge係数SD |
|---|---|---|---|---|
| X1 | 0.680 | 0.698 | 0.136 | 0.056 |
| X2 | 1.158 | 0.927 | 0.127 | 0.053 |
| X3 | 0.339 | 0.536 | 0.131 | 0.055 |
| X4 | 0.726 | 0.728 | 0.122 | 0.054 |
| X5 | -0.552 | -0.617 | 0.139 | 0.052 |
| X6 | -0.478 | -0.599 | 0.141 | 0.055 |
| X7 | -1.015 | -0.821 | 0.133 | 0.048 |
| X8 | 0.644 | 0.708 | 0.145 | 0.049 |
| X9 | 0.866 | 0.788 | 0.143 | 0.047 |
| X10 | 0.295 | 0.290 | 0.020 | 0.020 |
10特徴量の係数標準偏差を平均すると、LinearRegressionは0.124、Ridgeは0.049でした。特徴量ごとの「Ridge係数SD ÷ OLS係数SD」の中央値は0.403です。今回の人工データでは、予測性能がほぼ同程度でも、Ridgeの方が学習データの変化に対する係数の揺れを小さくできました。
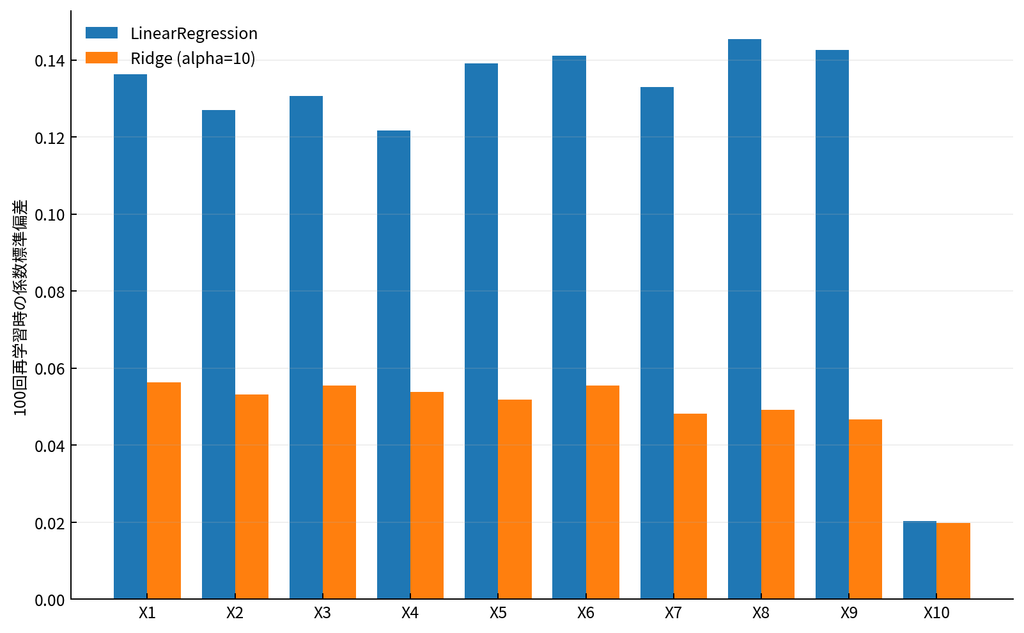
値が小さいほど、学習データの変化に対して係数が安定していたことを示します。
この結果はRidgeの一般的優位性を証明するものではありません。人工データの相関構造を強く設定したため、正則化による係数安定化が見えやすい実験です。実データでは、サンプル数、相関構造、ノイズ、目的変数、alphaなどによって結果は変わります。
Ridge回帰を実務で使う際の注意点
特徴量の標準化
RidgeのL2ペナルティは係数の大きさへ作用します。売上額のような数千単位の変数と、比率のような0〜1の変数をそのまま混在させると、係数の尺度も変わります。正則化を各特徴量へ同程度の尺度感で作用させたい一般的な利用では、標準化を検討することが重要です。
scikit-learnのStandardScalerは、学習データから平均と標準偏差を計算し、各特徴量を標準化します。実務では、テストデータや将来データを使ってスケーラーを学習しないよう、Pipelineに入れて学習データ内で処理する方法が安全です。
係数は因果効果ではない
Ridgeで得た係数も、通常の回帰係数と同様に因果効果を直接意味するわけではありません。係数が正だからその変数を増やせば目的変数が上がる、係数が小さいから業務上重要でない、といった解釈は避けます。
Ridgeは変数選択手法ではない
Ridgeは通常、係数を小さくしますが厳密な0にはしにくいため、特徴量を自動的に削除することを主目的とした方法ではありません。「係数が小さくなったから削除する」と機械的に判断せず、業務上の意味や予測性能、データ取得コストも含めて検討します。
多重共線性そのものが消えるわけではない
Ridgeを学習してもX1とX2の相関係数が変わるわけではありません。Ridgeは係数推定へペナルティを加えることで、相関の強い特徴量がある場合の不安定性を緩和する方法です。データの重複や定義上ほぼ同じ変数が存在するなら、そもそもの特徴量設計を見直すことも必要です。
時系列データでは評価方法にも注意する
今回の人工データは独立した観測としてランダム分割しています。しかし、売上・需要・設備状態など時間順序を持つデータでは、過去で学習して未来で評価するなど、実運用に対応した分割方法が必要です。alpha選択の交差検証も、データ構造に合わせて設計します。
実務では「Ridgeを使うか」より分析設計が先にある
Ridge回帰はPythonで数行あれば実装できます。しかし、実務で難しいのはモデル名を決めることより、「何を予測・説明したいのか」「どの時点で利用できる説明変数か」「似た変数が複数あるのはなぜか」「予測精度と係数解釈のどちらを重視するか」を整理することです。
例えば予測だけが目的なら、係数が多少変動していても未知データの誤差が十分小さければ使える場合があります。一方、経営企画で「どのKPIがどの程度関係しているか」を説明したい場合は、係数の安定性や変数定義の方が重要になることがあります。
Ridgeを使うこと自体をゴールにせず、分析目的と評価基準を先に置くことが重要です。Ridge・Lassoを含む正則化全体の基本を確認したい場合は、SCI-Naviの「Ridge回帰とLasso回帰とは?正則化の基礎・ビジネス活用例・Python実装を解説」もあわせてご覧ください。
通常の線形回帰そのものから確認したい場合は、「線形回帰とは?単回帰・重回帰で解けるビジネス課題とPython実装例」が前提記事として利用できます。
まとめ:Ridge回帰は係数を縮小し、安定性とのバランスを取る
- Ridge回帰は通常の線形回帰にL2正則化を加えたモデルである
- 目的関数は残差平方和と係数二乗和のペナルティから構成される
- alphaが大きいほど係数は強く0方向へ縮小する
- alphaを大きくすれば常に良いわけではなく、強すぎる正則化はアンダーフィットにつながり得る
- 相関の強い特徴量ではRidgeが係数推定を安定させる方向に働く
- 多重共線性そのものが消えるわけではない
- 特徴量の尺度が違う場合は標準化を検討する
- alphaは学習データ内の交差検証で選び、最終テストデータとは分離する
- 予測精度だけでなく係数安定性や業務上の解釈も確認する
今回の人工データでは、LinearRegressionとRidgeのテストR²はともに約0.943でほぼ同程度でした。一方、100回の再学習における係数標準偏差の平均は0.124から0.049へ低下しました。これは今回の人工データに対する結果であり、すべての実務データで同じ結果になることを意味しません。
SCI総合研究所株式会社のRASHINRAでは、売上・営業・需要・業務データなどについて、分析目的の整理、データ設計、回帰モデルを含む手法比較、評価指標の設計、結果の解釈、意思決定への活用までを支援しています。Ridge回帰を使うこと自体ではなく、自社データからどのような判断材料を作るべきか整理したい場合はご相談ください。
参考文献
- Hoerl, A. E. and Kennard, R. W. 1970. Ridge Regression: Biased Estimation for Nonorthogonal Problems. Technometrics. Vol. 12. Issue 1. pp. 55-67. https://doi.org/10.1080/00401706.1970.10488634
- Pedregosa et al. 2011. Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research. Vol. 12. pp. 2825-2830. https://www.jmlr.org/papers/v12/pedregosa11a.html