
回帰分析で使える説明変数が20個、30個と増えてくると、「すべてをモデルへ入れるべきか」「本当に使う変数を絞れないか」という課題が出てきます。こうした場面で候補になる方法の一つがLasso回帰です。
Lasso回帰は、通常の線形回帰へL1正則化を加えたモデルです。係数の絶対値の和にペナルティを与えることで係数を縮小し、条件によっては一部の係数を厳密に0にできます。Lassoは、係数の縮小と変数選択を同時に行う方法として提案されました(Tibshirani, 1996)。
ただし、「係数が0になった特徴量は不要」「残った特徴量が重要KPI」と単純に判断できるわけではありません。選択結果はalpha、サンプル、ノイズ、他の特徴量との相関などに依存します。本記事では、20特徴量のうち5特徴量だけが真に目的変数へ影響する人工データを作り、PythonでLassoの係数が0になる過程、alpha選択、特徴量選択の安定性まで確認します。使用するデータはすべて説明用の人工データで、実在企業や実案件とは関係ありません。
Lasso回帰とは
Lassoは線形回帰にL1正則化を加えたモデル
通常の線形回帰では、実測値と予測値の差である残差の二乗和を小さくするように回帰係数を求めます。Lassoでは、そこへ係数の絶対値の和であるL1ペナルティを加えます。
(1 / 2n) × ||y − Xw||²₂ + α||w||₁
ここで、yは目的変数、Xは説明変数、wは回帰係数、α(alpha)は正則化の強さです。scikit-learnのLassoもこの形の目的関数を最小化する線形モデルとして実装され、座標降下法によって解かれます(Pedregosa et al., 2011)。
「スパースなモデル」とは何か
多くの係数が0で、一部だけが非ゼロになっている状態をスパースと呼びます。20特徴量のうち6特徴量だけに非ゼロ係数があれば、残り14特徴量はそのLassoモデルの予測式には直接使われません。
この性質により、Lassoは多数の候補変数からモデルが利用する変数を絞る目的にも使えます。ただし、これは「経営上重要なKPIを自動的に判定する」という意味ではありません。あくまで、与えられたデータと目的関数の下でスパースな回帰係数を推定していると理解する必要があります。
L1正則化でなぜ係数が0になるのか
L1正則化では、係数の絶対値を合計した|w₁| + |w₂| + …へペナルティを与えます。L2正則化のように係数の二乗を滑らかに抑えるのではなく、絶対値は0の位置で折れ曲がる形を持ちます。この性質によって、損失を最小化する解が係数0の位置に到達しやすくなります。
数理的には、L1制約の領域には座標軸上の角があり、誤差を表す等高線がその角へ接する場合に一部係数が0になります。これが、Lassoが係数を単に小さくするだけでなく、厳密な0を作りやすい理由です(Tibshirani, 1996)。
alphaは何を調整しているのか
- alphaが小さい:予測誤差を小さくすることを優先し、通常の線形回帰に近い。
- alphaが中程度:予測誤差と係数のスパース化のバランスを取る。
- alphaが大きい:より多くの係数を0方向へ縮める一方、必要な変数まで抑える可能性がある。
したがって、alphaは大きければよいわけではありません。また、今回の実験で選ばれたalphaを他のデータへそのまま使うことも適切ではありません。
Lasso回帰が特徴量選択にも使われる理由
Lassoでは係数が0になった特徴量は予測式から外れた状態になります。そのため、非ゼロ係数の特徴量だけを抽出すれば、モデルで使用する特徴量の候補を減らせます。
一方、係数0は「その特徴量が目的変数と無関係である」という判定ではありません。正確には、選択されたalpha、与えられた学習データ、同時に投入した他の特徴量の条件下で、そのLasso解では係数0になったという意味です。
例えば似た情報を持つX2とX3があれば、LassoがX2だけを残しX3を0にする場合があります。しかし、X3が業務上無意味とは限りません。X2が同じ情報をすでに持っていたため、予測式へ追加する必要性が小さかった可能性があります。
20特徴量中5特徴量だけが効く人工データを作る
今回は600件、20特徴量の人工データを作りました。目的変数へ真に影響する特徴量はX2、X5、X9、X13、X18の5つだけです。
y = 4.0X2 − 3.0X5 + 2.5X9 + 1.8X13 − 2.2X18 + ε
残り15特徴量の真の係数は0です。また、単純すぎる人工データを避けるため、X3をX2と、X10をX9と相関係数がおおむね0.55程度になるよう人工生成しました。目的変数には標準偏差1.4のランダムノイズも加えています。
この設定には「真に有効な特徴量」が分かっているという人工データ特有の利点があります。実務データでは真の係数を知ることはできないため、今回の実験はLassoの挙動を理解するための教材と位置付けます。
LinearRegressionとLassoを比較する
StandardScalerを含むPipelineで学習する
L1ペナルティは係数の大きさへ作用します。そのため、特徴量ごとに単位やスケールが大きく違う場合、標準化せずにLassoを使うとペナルティの効き方を比較しにくくなります。今回はStandardScalerをPipelineへ入れ、学習データから平均と標準偏差を計算して標準化した後にLassoを学習します。
from sklearn.pipeline import Pipelinefrom sklearn.preprocessing import StandardScalerfrom sklearn.linear_model import Lassomodel = Pipeline([ ("scaler", StandardScaler()), ("lasso", Lasso(alpha=0.1))])model.fit(X_train, y_train)pred = model.predict(X_test)テストデータ側でスケーラーを学習すると情報漏洩につながるため、前処理とモデルをPipelineにまとめる方法が扱いやすいです。比較するLinearRegression側も同じくStandardScalerを通しています。
LassoCVでは20特徴量中6特徴量が残った
600件のうち450件を学習データ、150件をテストデータとしました。学習データ内部の5分割交差検証でalphaを選択した結果、今回の人工データではalpha=0.0890が選ばれました。
LinearRegressionでは20特徴量すべてに非ゼロ係数が付きました。一方、LassoCVでは6特徴量が非ゼロになり、X2、X5、X7、X9、X13、X18が残りました。真に有効な5特徴量はすべて残りましたが、真の係数が0であるX7も小さな非ゼロ係数として残っています。
つまり、今回のLassoは20特徴量を6特徴量まで絞りましたが、「真の5特徴量を完全に識別した」わけではありません。この結果は、Lassoを特徴量選択へ利用するときの注意点をそのまま示しています。
| モデル | alpha | R² | MAE | RMSE | 非ゼロ係数数 |
|---|---|---|---|---|---|
| LinearRegression | ― | 0.949 | 1.190 | 1.468 | 20 |
| LassoCV | 0.0890 | 0.946 | 1.215 | 1.502 | 6 |
今回のテストデータでは、LinearRegressionのR²は0.949、Lassoは0.946でした。MAEはそれぞれ1.190、1.215です。予測性能は近い一方、Lassoでは利用する係数が20個から6個へ減っています。
ただし、これは「Lassoの方が優れている」という結果ではありません。今回のテストR²はLinearRegressionの方がわずかに高く、スパース化との交換条件が存在します。特徴量を減らすこと、予測精度を高めること、説明しやすくすることは、同じ目的ではありません。
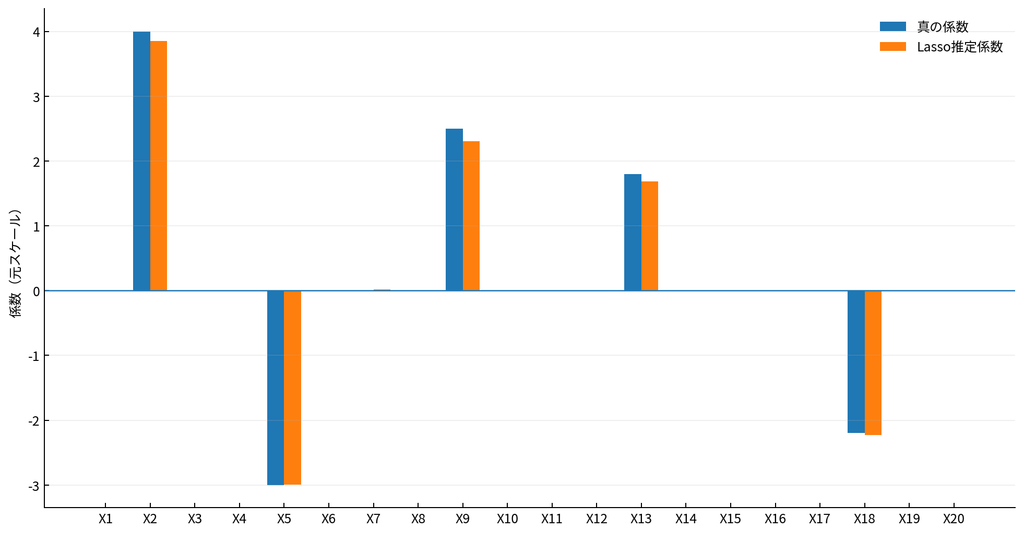
推定係数はStandardScalerでの学習後に元スケールへ戻して表示しています。真に有効な5特徴量は非ゼロで残り、X7もごく小さな係数で残りました。
coef = model.named_steps["lasso"].coef_selected = pd.DataFrame({ "feature": X_train.columns, "coefficient": coef, "selected": np.abs(coef) > 1e-10})selectedalphaを変えると特徴量数はどう変わるか
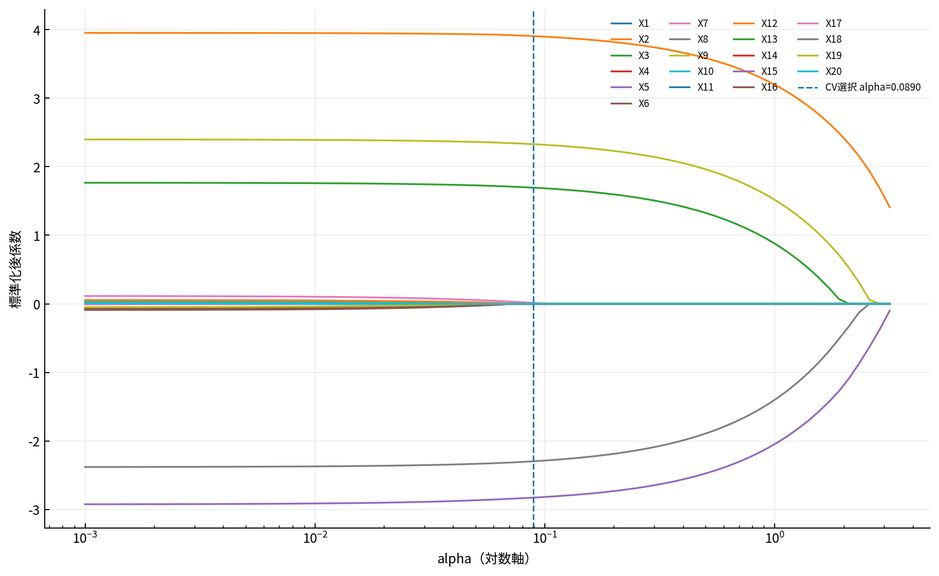
次に、alphaを0.001から約3.16まで対数スケールで変化させました。各alphaで同じ学習データへLassoを当て、20個の係数を保存しています。
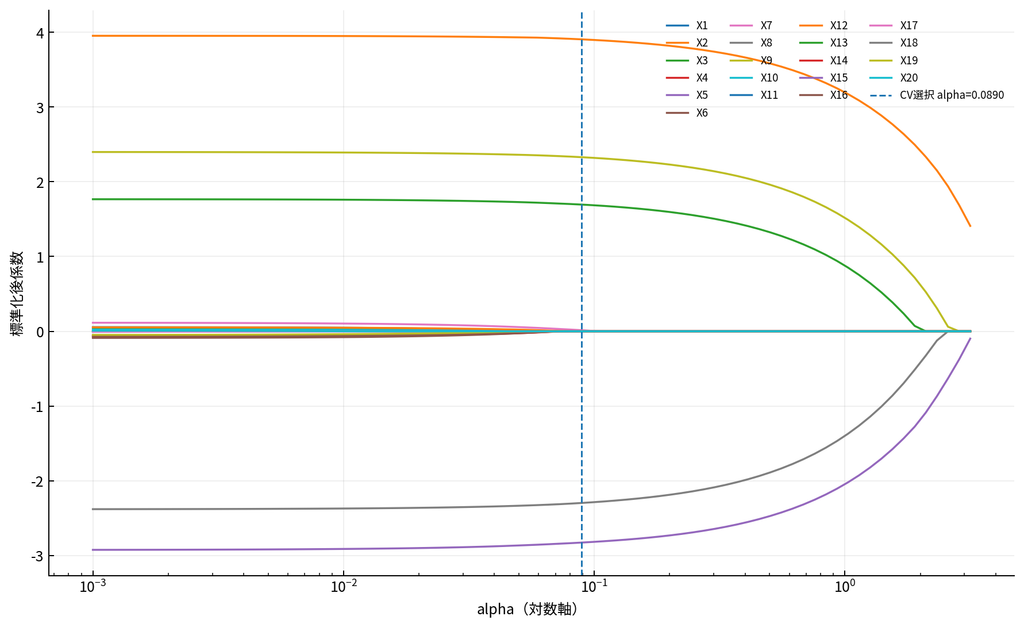
alphaが小さい領域では多くの係数が非ゼロですが、正則化を強めると各係数が0へ到達していきます。破線は今回LassoCVで選択されたalphaです。
このように正則化パラメータに対する係数の変化を追ったものを正則化パスと呼びます。1つのalphaで得られた係数だけを見るより、「どの程度正則化すると変数が落ちるのか」を把握しやすくなります。
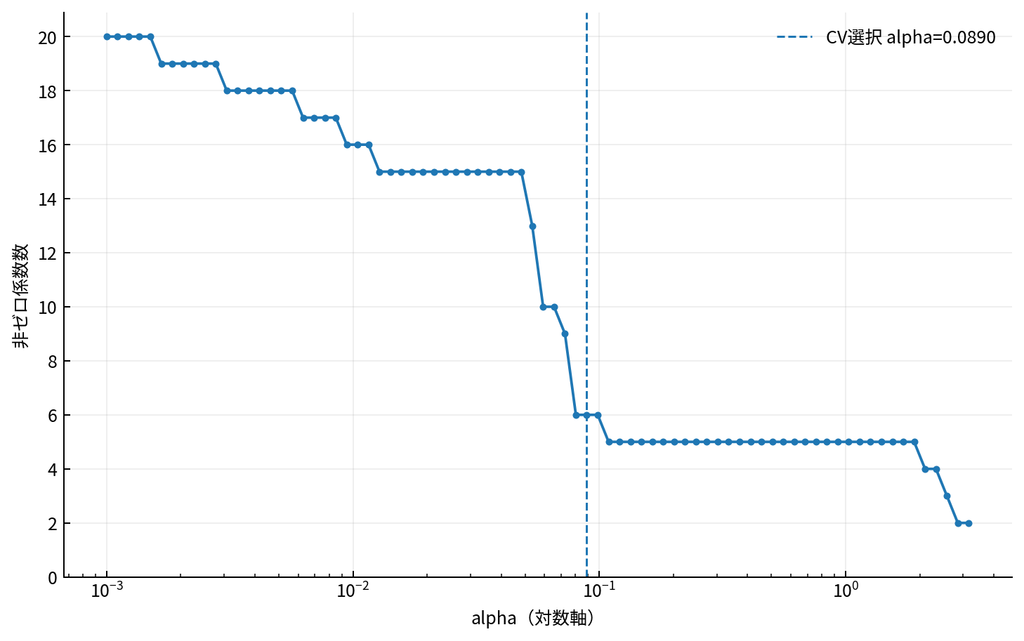
alphaを強めるほどモデルがスパースになり、使用する特徴量数が減っていきます。
ここで重要なのは、「特徴量数を5個にすれば真の5特徴量が得られる」とは限らないことです。どの変数が0になるかは、データのノイズや相関、サンプル数にも左右されます。特徴量数だけを目標にalphaを調整する方法は避ける方が安全です。
alphaをどう選ぶか
テストデータでalphaを選ばない
複数のalphaをテストデータへ試し、最も成績の良かったalphaを採用した後、その同じテストデータのR²を最終性能として報告すると、テストデータをモデル選択に使ったことになります。
今回は学習データ450件の中で5分割交差検証を行い、平均二乗誤差を基準にalphaを選びました。その後、選択したモデルを独立した150件のテストデータで評価しています。
from sklearn.model_selection import KFoldfrom sklearn.linear_model import LassoCValphas = np.logspace(-3, 0.5, 80)cv = KFold(n_splits=5, shuffle=True, random_state=42)model = Pipeline([ ("scaler", StandardScaler()), ("lasso", LassoCV( alphas=alphas, cv=cv, max_iter=50000 ))])model.fit(X_train, y_train)best_alpha = model.named_steps["lasso"].alpha_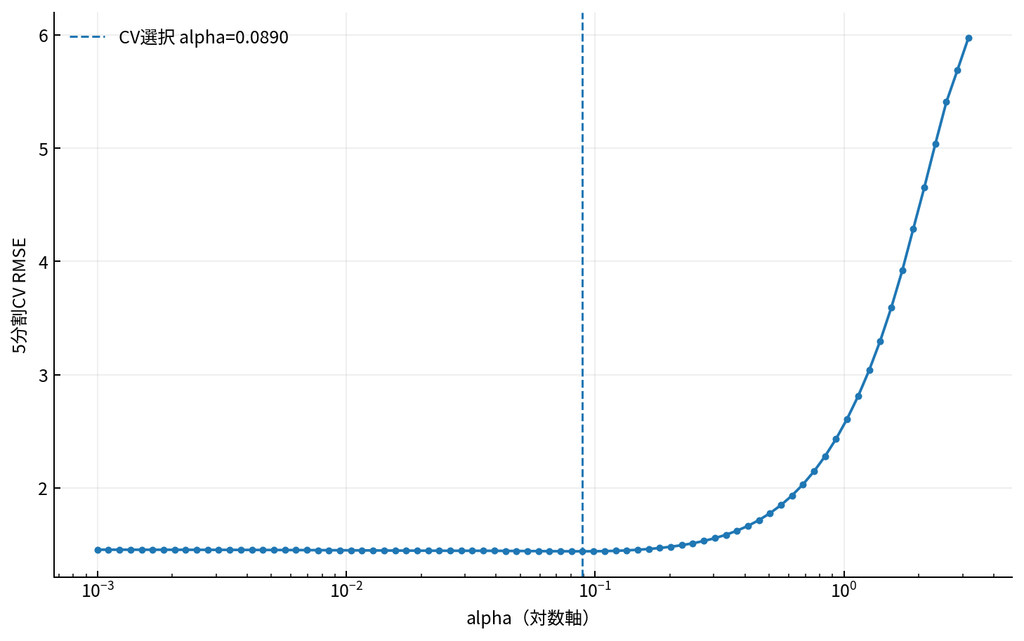
今回の条件ではalpha=0.0890付近が選択されましたが、この値は人工データの条件、alpha候補、交差検証の分割方法によって変わります。
また、交差検証で予測誤差が最小のalphaを選ぶことと、「最も解釈しやすい特徴量数を選ぶこと」は必ずしも一致しません。予測目的なのか、説明変数を整理したいのか、分析目的を先に明確にする必要があります。
Lassoによる特徴量選択は安定しているか
1回の学習でX7の係数が非ゼロになったからといって、別のサンプルでも常にX7が残るとは限りません。そこで、学習データ450件のうち80%をランダムに抽出して100回Lassoを再学習し、各特徴量が非ゼロだった割合を「選択率」として計算しました。alphaは最初のLassoCVで選択された値に固定しています。
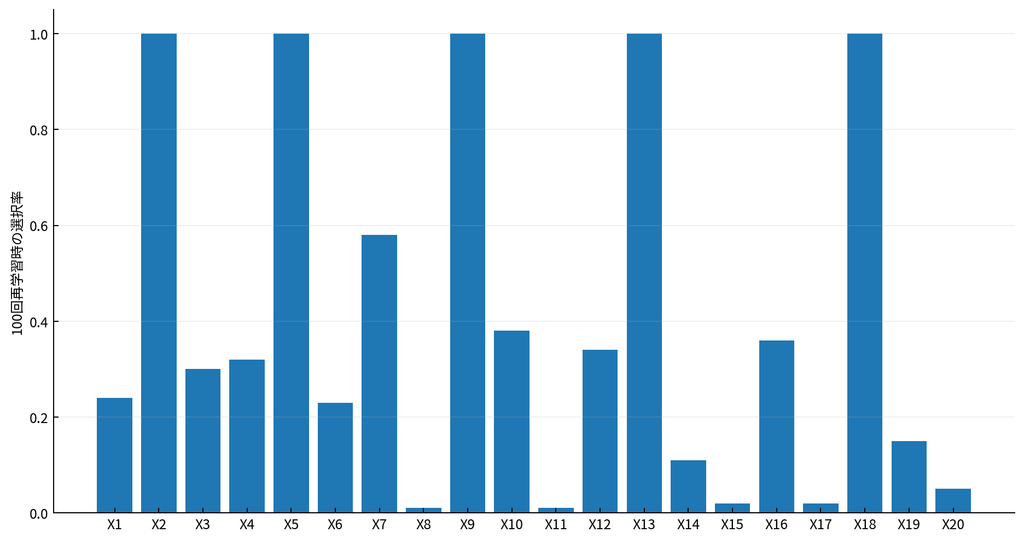
真に有効なX2、X5、X9、X13、X18はすべて100%選択されました。一方、真の係数が0のX7は58%、X10は38%、X3は30%でした。
X3はX2と、X10はX9と人工的に相関させた特徴量です。今回の最終モデルではX3とX10は0でしたが、データを一部変えると非ゼロになる回がありました。これは、相関した特徴量が存在すると「どちらを残すか」が学習データに影響される可能性を示しています。
| 特徴量 | 真の係数 | Lasso係数 | 最終モデル | 100回選択率 |
|---|---|---|---|---|
| X1 | 0.0 | 0.000 | 0 | 24% |
| X2 | 4.0 | 3.854 | 選択 | 100% |
| X3 | 0.0 | 0.000 | 0 | 30% |
| X4 | 0.0 | -0.000 | 0 | 32% |
| X5 | -3.0 | -2.997 | 選択 | 100% |
| X6 | 0.0 | -0.000 | 0 | 23% |
| X7 | 0.0 | 0.015 | 選択 | 58% |
| X8 | 0.0 | 0.000 | 0 | 1% |
| X9 | 2.5 | 2.308 | 選択 | 100% |
| X10 | 0.0 | 0.000 | 0 | 38% |
| X11 | 0.0 | 0.000 | 0 | 1% |
| X12 | 0.0 | 0.000 | 0 | 34% |
| X13 | 1.8 | 1.686 | 選択 | 100% |
| X14 | 0.0 | -0.000 | 0 | 11% |
| X15 | 0.0 | 0.000 | 0 | 2% |
| X16 | 0.0 | -0.000 | 0 | 36% |
| X17 | 0.0 | -0.000 | 0 | 2% |
| X18 | -2.2 | -2.226 | 選択 | 100% |
| X19 | 0.0 | -0.000 | 0 | 15% |
| X20 | 0.0 | 0.000 | 0 | 5% |
この表で特に重要なのは、選択率の高い特徴量が必ず「真の変数」とは限らず、逆に1回のモデルで0だった特徴量も別サンプルでは選択される可能性があることです。実務では真の係数を知れないため、1回のLasso結果だけを変数削除ルールにするのは慎重に考える必要があります。
LassoをPythonで動かし、非ゼロ係数を抽出すること自体は難しくありません。一方、自社データでは「候補KPIを最初にどう定義するか」「相関した変数をどう扱うか」「どの程度の選択安定性を求めるか」という分析設計が結果の解釈を大きく左右します。
Lassoを実務で使うときの注意点
係数0=業務上不要ではない
係数0は、そのモデルが予測式へその特徴量を使わなかったことを意味します。データ取得を止めてよい、KPI管理をやめてよい、施策として意味がない、といった結論まで自動的に導けるものではありません。
例えば似た情報を持つ2つのKPIがあれば、一方だけを残しても予測できることがあります。しかし、業務管理上は両方が異なる役割を持つ場合があります。モデル上の冗長性と業務上の不要性は分けて考えます。
非ゼロ係数=因果的に重要ではない
Lassoの係数は観測データに対して目的関数を最小化した結果です。非ゼロだから、その変数を操作すれば目的変数が増減するという因果効果を意味するわけではありません。経営施策の効果を知りたい場合は、交絡や施策選択の偏りなど別の問題を考える必要があります。
相関の強い特徴量では選択が入れ替わることがある
相関した特徴量のうち一方だけで予測情報を十分に表現できる場合、Lassoは一方を残してもう一方を0にすることがあります。学習データを変えると残る側が入れ替わる可能性もあるため、相関行列や特徴量定義を合わせて確認します。
alpha=0でLassoをOLS代わりに使わない
Lassoの目的関数ではalpha=0にすると通常の最小二乗法と同じ形になります。ただし、scikit-learnでは数値計算上の理由からLasso(alpha=0)をOLSの代わりに使うことは推奨されていません。通常の線形回帰との比較にはLinearRegressionを使います。
選択結果だけで業務KPIを削除しない
モデルの目的が将来予測なら、取得コストの高い特徴量を減らせることに価値がある場合があります。一方、経営企画で説明材料として使う場合は、KPIの意味や組織の管理単位まで考える必要があります。Lassoの選択結果は、候補を整理するための分析材料の一つと位置付ける方が実務では扱いやすいでしょう。
線形回帰・Ridge・Lassoをどうつなげて理解するか
Lassoを理解する前提として通常の線形回帰を確認したい場合は、SCI-Naviの「線形回帰とは?単回帰・重回帰で解けるビジネス課題とPython実装例」をご覧ください。
正則化全体とRidge・Lassoの違いを先に整理したい場合は、「Ridge回帰とLasso回帰とは?正則化の基礎・ビジネス活用例・Python実装を解説」が関連します。今回の記事は、その中でもLassoの係数0、alpha、特徴量選択、選択安定性を深掘りする位置付けです。
Ridge回帰ではL2正則化によって係数を縮小しますが、一般にはLassoほど厳密な0を作ることを目的としません。SCI-NaviでRidge単体の記事を公開した後は、L1正則化とL2正則化を相互リンクすると、正則化の違いを実装結果から比較しやすくなります。
まとめ:Lassoは特徴量を絞る手掛かりだが、自動判定ではない
- Lasso回帰は通常の線形回帰にL1正則化を加えたモデルである
- L1ペナルティは係数の絶対値の和に作用し、一部の係数を厳密に0にできる
- alphaが大きいほど正則化が強くなり、非ゼロ係数数は減る方向に変化する
- alphaは学習データ内の交差検証で選び、独立したテストデータで最終評価する
- 今回の人工データでは20特徴量から6特徴量まで絞られ、真の5特徴量はすべて残ったが、X7も非ゼロになった
- 係数0は業務上不要という意味ではなく、非ゼロ係数も因果的重要性を表さない
- 相関した特徴量やデータの変化によって、選択結果が入れ替わることがある
- 実務では予測性能、選択安定性、KPIの業務上の意味を合わせて判断する
今回の人工データでは、LinearRegressionとLassoのテストR²は0.949と0.946で近い一方、Lassoは非ゼロ係数を20個から6個へ減らしました。しかし、真の係数0であるX7も残っています。このように、Lassoは特徴量を絞る有力な手掛かりになりますが、「残った変数が正解」という自動判定ではありません。
SCI総合研究所株式会社のRASHINRAでは、売上・営業・マーケティング・業務データなどを対象に、分析テーマの整理、KPI・説明変数の設計、回帰モデルを含む手法比較、結果の解釈、意思決定への活用までを支援しています。Lassoで変数を減らすこと自体を目的とせず、自社の判断に必要なデータや指標を整理したい場合はご相談ください。
参考文献
- Tibshirani, R. 1996. Regression Shrinkage and Selection via the Lasso. Journal of the Royal Statistical Society Series B. Vol. 58. Issue 1. pp. 267-288. https://doi.org/10.1111/j.2517-6161.1996.tb02080.x
- Pedregosa et al. 2011. Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research. Vol. 12. pp. 2825-2830. https://www.jmlr.org/papers/v12/pedregosa11a.html