
生産ラインのボトルネックを考えるとき、平均処理時間が長い工程へ注目しやすくなります。しかし、平均値が極端に大きくなくても、処理時間のばらつきが大きい工程ではjobの到着間隔とresource occupancyがずれ、待ち行列が生じることがあります。今回は、180件のjobが8工程を流れるSynthetic lineを作り、その歪みをtrajectoryとして可視化しました。
この図は何を表しているのか
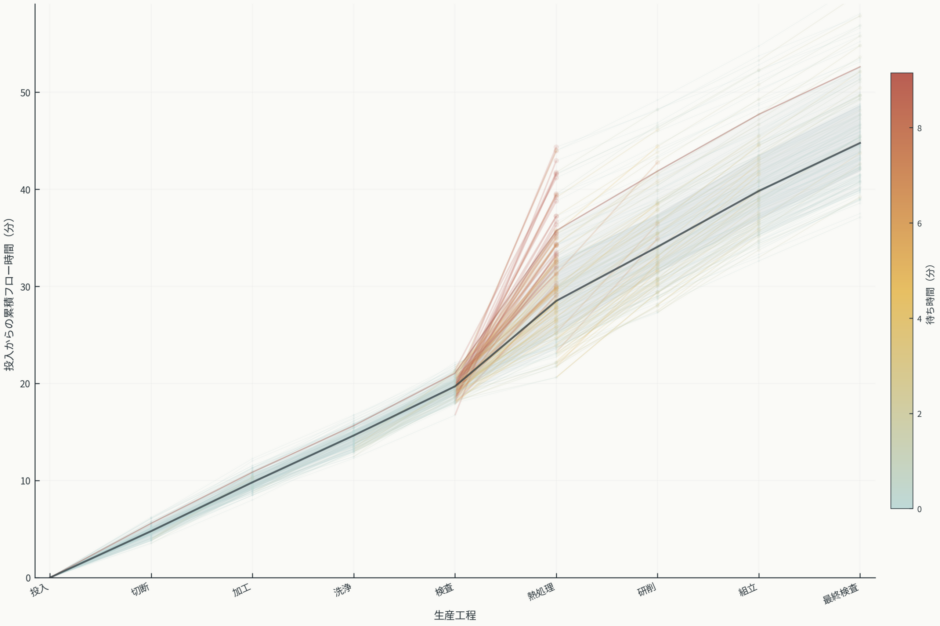
横方向にはReleaseからFinal testまでの工程を並べています。縦方向は各jobが投入されてから、その工程を完了するまでにかかった累積flow timeです。
細いlineは1本が1 jobです。工程間のsegment colorは、到着後にresourceが空くまで待ったqueue waiting timeを表します。待ち時間が大きいほどwarmな色へ変化します。
各工程上の小さなpointもwaiting timeを表し、長く待ったjobほど大きくなります。薄いribbonはjob全体のflow-time distributionで、外側が10–90%、内側が25–75%です。濃いlineはmedian、弱いwarm lineは90 percentileを示します。
可視化から読み取れること
今回のActual scenarioではHeat treatmentの平均処理時間は5.55分で、CVは0.51でした。Heat treatmentの平均queue waiting timeは4.00分で、ライン全工程の平均waiting time合計のうち63.6%がこの工程に集中しました。
Visual上でもHeat treatment付近でtrajectoryが急に広がり、その後のGrinding、Assembly、Final testへflow-time dispersionが残ります。
Final flow timeの平均はActualで45.74分、P95は55.84分でした。10–90% spreadは12.65分です。
この構造をどう解釈するか
今回のGround TruthではHeat treatmentだけprocessing-time CVを高くしています。平均処理時間は5.55分であり、他工程と大きく異なる値にはしていません。
処理時間が短いjobの後に長いjobが来ると、Heat treatment resourceのavailable timeが不規則になります。到着側は比較的規則的でも、service completionが揺らぐため一部jobが待たされ、そのqueueが後続jobへ引き継がれます。
さらにHeat treatmentを抜けた時点でjob spacing自体が歪むため、GrindingやAssemblyでも一時的なqueueが生じます。このためbottleneckは一点の遅延ではなく、flow trajectoryのfan-outとして下流へ残ります。
可視化の仕組み
180 jobsを6.2分間隔で投入し、Cutting、Milling、Washing、Inspection、Heat treatment、Grinding、Assembly、Final testの8工程へ順に流しました。
すべての工程はsingle-server FIFOです。Processing timeはlognormal distributionから生成し、Heat treatmentだけCVを高く設定しました。
Main Visualizationでは各jobのcumulative flow timeを工程ごとに結び、destination stageでのwaiting timeをsegment colorとlinewidthへ割り当てています。これにより、単なる処理時間の長さではなくqueueが発生した位置をflow structureとして残しています。
なぜこの可視化方法を選んだのか
Stage別の平均waiting timeを比較すれば、どの工程にqueueが多いかは確認できます。一方、今回見たいのは、そのqueueがjobの流れ全体をどのように歪めるかです。
Production flow congestion mapでは、全jobを同じ工程軸の上へtrajectoryとして重ねられます。そのため、ある工程でlineが広がり、その歪みが後続工程へ残る様子を一枚のflow fieldとして確認できます。
実データへの応用可能性
実データでは、job ID、工程順、各工程のarrival / start / completion timestamp、resource IDがあれば、同様のflow distortionを探索できる可能性があります。
たとえば平均processing timeが大きく変わっていないにもかかわらず、特定工程のvariance上昇とともにqueueが増えていないか、またその影響が後工程へどの程度残るかを確認できます。
実ラインではparallel machine、buffer capacity、priority rule、reworkなども関係するため、それらを含めたprocess modelが必要になる場合があります。
データと分析方法
今回はSynthetic Dataを使用しています。Job数は180、工程数は8、乱数シードは260927です。
Heat treatmentの平均processing timeを5.55分に固定し、ActualではCV 0.51、CounterfactualではCV 0.11としました。両scenarioでは同じuniform random rankを利用しています。
CounterfactualでHeat treatmentのvariationだけを抑えると、同工程の平均waiting timeは4.00分から0.48分へ低下しました。
Final flow timeのP95も55.84分から42.65分となり、ActualはCounterfactualより30.9%大きい値でした。
このVisualization Studyの限界
今回の生産ラインはSynthetic Dataであり、実際の工場を再現したものではありません。
各工程はsingle-server FIFOで、machine breakdown、setup、parallel machine、buffer limit、priority rule、reworkを含みません。実ラインではこれらがbottleneck structureを変える可能性があります。
また、CounterfactualはHeat treatmentの平均を固定しCVだけを変更していますが、現実の改善策がvarianceだけを独立に変えられるとは限りません。
したがって、今回の30.9%という差を現実の改善効果として一般化することはできません。確認しているのは、平均処理時間が同じでもprocessing-time variabilityが大きいDGPではqueueが集積し、downstream flow-time distributionまで歪み得るという構造です。
まとめ
今回は、工程時間のばらつきが生産ライン全体のflowへどのように残るかをProduction flow congestion mapとして可視化しました。
Synthetic DataではHeat treatmentへwaiting timeが集中し、そこでtrajectoryが扇状に広がりました。平均処理時間を変えずにばらつきだけを抑えたcounterfactualでは、queueとfinal flow-time dispersionが小さくなりました。
この見方は、工程ごとの平均値だけでなく、jobの流れがどこで歪み、その歪みがどこまで残るかを探索するための一つの方法になります。