
Random Forest(ランダムフォレスト)を使ったことがある方がscikit-learnのモデル一覧を見ると、Extra Trees(Extremely Randomized Trees)という名前に出会うことがあります。どちらも多数の決定木を組み合わせるため、実装上はよく似ています。しかし、木を作る際のランダム性の入れ方には重要な違いがあります。
大まかに言えば、Random Forestは各ノードで候補となる特徴量から良い分割点を探索するのに対し、Extra Treesは候補特徴量について分割しきい値自体もランダムに生成し、その中から分割を選びます。Extra Treesの「Extra」は、Random Forestよりさらにランダム化を加える設計に由来します(Geurts et al., 2006)。
ただし、Extra Treesを「Random Forestの高速版」や「上位互換」と捉えるのは適切ではありません。予測精度、学習時間、特徴量の使われ方はデータや設定によって変わります。本記事では、2,400件の人工売上データにRandomForestRegressorとExtraTreesRegressorを適用し、学習時間、MAE、R²、特徴量重要度を同じ評価条件で比較します。
Extra Treesとは
Extremely Randomized Treesの基本
Extra Treesは「Extremely Randomized Trees」の略称で、複数のランダム化された決定木を組み合わせて予測するアンサンブル学習です。分類にも回帰にも利用でき、scikit-learnでは分類用のExtraTreesClassifierと回帰用のExtraTreesRegressorが提供されています。
基本的な発想は、単独の決定木に強く依存せず、異なる木を多数作って予測を集約することです。回帰では各木の予測を平均し、分類では複数木の出力を集約します。多数の木を組み合わせる点はRandom Forestと共通しています。
Random Forestと共通している点
Random ForestもExtra Treesも、決定木にランダム性を導入して木同士の相関を下げ、多数の木を集約することで単独の木より安定した予測を目指します。Random ForestはBreimanによって体系化された代表的な木ベースのアンサンブル手法です(Breiman, 2001)。
- 複数の決定木を学習する
- 各分割で利用する特徴量にランダム性を持たせられる
- 分類・回帰の双方に利用できる
- 非線形な関係や変数間の相互作用を表現できる
- 学習後に不純度減少に基づく特徴量重要度を取得できる
そのため、実装コードだけを見ると両者は非常によく似ています。重要なのは、同じ「木をたくさん作るモデル」でも、各木をどのようにランダム化して作るかが異なる点です。
Random Forestとの最大の違いは分割方法
通常の決定木では、あるノードを分ける際に、候補となる特徴量としきい値を評価し、不純度を大きく減らせる分割を選びます。Random Forestでも、各ノードで検討する特徴量をランダムに絞った上で、その候補の中から良い分割を探索します。
Extra Treesでは、さらに一段ランダム化します。ランダムに選ばれた各候補特徴量についてしきい値もランダムに作り、そのランダム候補の中から良い分割を選びます。これにより木同士の違いを大きくし、アンサンブルとしての分散低減を狙います(Geurts et al., 2006)。
| 観点 | Random Forest | Extra Trees |
|---|---|---|
| 基本モデル | 決定木 | 決定木 |
| 複数木の集約 | 行う | 行う |
| 特徴量のランダム選択 | 行う | 行う |
| 分割しきい値 | 候補内で良い分割を探索 | ランダムなしきい値候補から選択 |
| scikit-learnのbootstrap既定値 | True | False |
| 分類・回帰 | 対応 | 対応 |
Random ForestとExtra Treesは何が違うのか
Random Forestはどのように木を作るか
Random Forestでは、一般に元の学習データから復元抽出したブートストラップ標本を各木へ与えます。さらに各ノードでは、全特徴量を毎回検討するのではなく、ランダムに選んだ一部の特徴量を候補にします。その候補の中で分割を評価し、良い分割を選びます。
scikit-learnのRandomForestRegressorではbootstrapの既定値はTrueです。一方で、max_featuresや木の深さなどは利用目的に応じて調整できます。Random Forestという名前から「分割点もランダムに置くモデル」と誤解されることがありますが、通常は候補内で分割の良さを評価して選びます。
Extra Treesは分割しきい値にもランダム性を加える
Extra Treesでは、分割候補となる特徴量をランダムに選ぶだけでなく、それぞれの特徴量についてランダムなしきい値候補を生成します。全候補しきい値を細かく探索するRandom Forestとは、ここが大きく異なります。
この違いによって計算量を抑えられる場合がありますが、実際の学習時間はデータ件数、特徴量数、木の本数、木の深さ、並列化、CPUなどに左右されます。そのため「Extra Treesは必ず高速」とはせず、実際の利用環境で測定する必要があります。
bootstrapの扱いも異なる
scikit-learnの標準設定では、Random Forestはbootstrap=True、Extra Treesはbootstrap=Falseです。つまり、標準的なRandom Forestでは各木がブートストラップ標本を使う一方、Extra Treesでは各木が学習データ全体を利用します。もちろんパラメータで変更できますが、既定値で比較すると「分割しきい値のランダム化」だけでなく、「各木へ与える学習データ」も異なります。
したがって、既定値に近い設定で学習時間や精度を比較した結果を、しきい値ランダム化だけの効果だと解釈してはいけません。本記事の比較も、実務で両モデルを候補にするときの参考比較であり、アルゴリズム要素を一つずつ切り分けるアブレーション実験ではありません。
バイアスとバリアンスから見る違い
Extra Treesの原論文では、入力特徴量と分割点のランダム化を強めることで分散を抑える方向に働く一方、ランダム化の程度によってはバイアスが増える可能性が議論されています(Geurts et al., 2006)。つまり、ランダム性を増やせば常に予測性能が高くなるわけではありません。
このトレードオフがあるため、Random ForestとExtra Treesは「どちらが上か」ではなく、「そのデータと目的でどちらの汎化性能が良いか」を検証する関係にあります。
Random ForestとExtra Treesを同じ人工データで比較する
今回使用する人工データ
ここからは、実在企業とは無関係の人工データ2,400件を使います。目的変数は「月間売上」、説明変数は広告費、Web訪問数、問い合わせ数、営業訪問数、平均単価、割引率、キャンペーン回数、既存顧客数、季節指数、前月売上、ノイズ変数2項目の計12項目です。
木モデルを比較する意味が出るように、データには単純な線形関係だけでなく、広告費の効果が一定水準で頭打ちになる関係、問い合わせ数の平方根的な効果、季節指数による非線形変化、割引率とキャンペーン回数の組み合わせによる相互作用を入れています。これは挙動説明のための人工的な生成規則であり、実際の売上形成を表すものではありません。
比較条件をそろえる
データは75%を学習用、25%をテスト用に分割しました。両モデルとも木の本数は300本、min_samples_leafは2、max_featuresは1.0、random_stateは42、n_jobsは1としています。bootstrapだけはscikit-learnの代表的な既定設定に合わせ、Random ForestをTrue、Extra TreesをFalseとしました。
from sklearn.ensemble import RandomForestRegressor, ExtraTreesRegressorcommon = dict( n_estimators=300, min_samples_leaf=2, max_features=1.0, random_state=42, n_jobs=1,)rf = RandomForestRegressor(**common, bootstrap=True)et = ExtraTreesRegressor(**common, bootstrap=False)学習時間は一度だけではなく、同じ条件で各モデルを5回学習し、その中央値を比較しました。n_jobs=1としているのは、今回のサンプル環境で並列実行の影響を減らし、アルゴリズム間の参考比較をしやすくするためです。実運用ではn_jobs=-1などで並列化するケースも多く、絶対的な秒数は環境によって変わります。
学習時間を比較する
今回の実行環境では、5回の学習時間中央値はRandom Forestが3.425秒、Extra Treesが1.349秒でした。この条件ではExtra Treesの方が短く、Random Forestの学習時間はExtra Treesの約2.54倍でした。
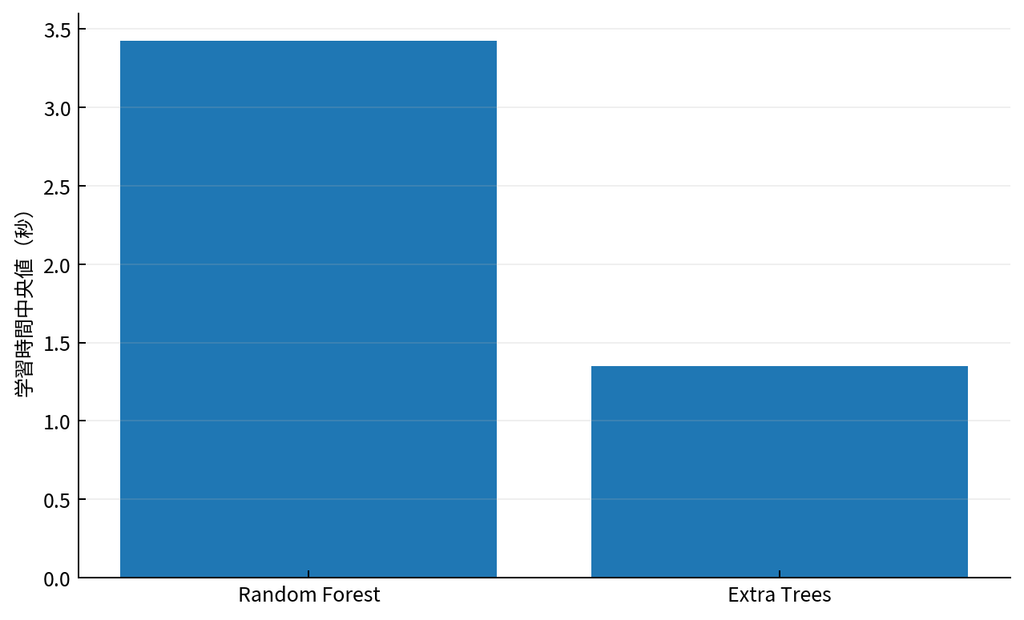
人工データ2,400件、300本の木、n_jobs=1、各5回測定した結果です。
ただし、この差を一般化することはできません。今回の比較ではExtra Treesが分割しきい値をランダムに選ぶことに加え、bootstrap設定も異なります。また、木の深さ、特徴量数、CPU、並列処理の設定が変われば差も変わります。「Extra Treesは何倍速い」と固定的に覚えるのではなく、自社データと実行環境で計測する方が安全です。
MAEとR²を比較する
テストデータでのMAEは、Random Forestが6.353、Extra Treesが6.263でした。R²はRandom Forestが0.814、Extra Treesが0.820です。この人工データではExtra Treesがわずかに良い値になりましたが、差は大きくありません。
| モデル | 学習時間中央値(秒) | MAE | R² |
|---|---|---|---|
| Random Forest | 3.425 | 6.353 | 0.814 |
| Extra Trees | 1.349 | 6.263 | 0.820 |
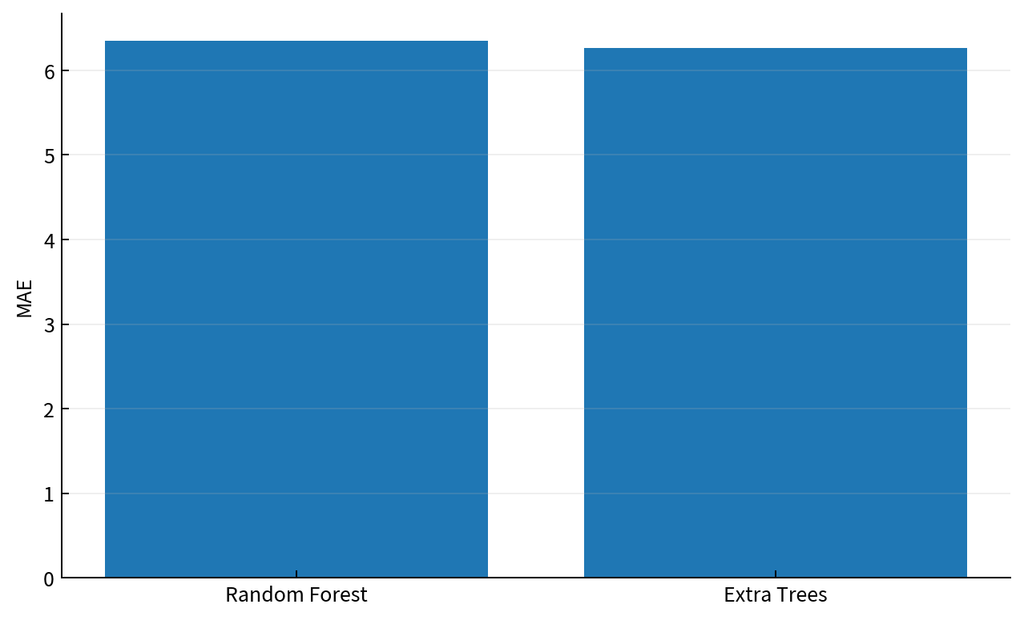
値が小さいほど平均的な絶対誤差が小さいことを示します。
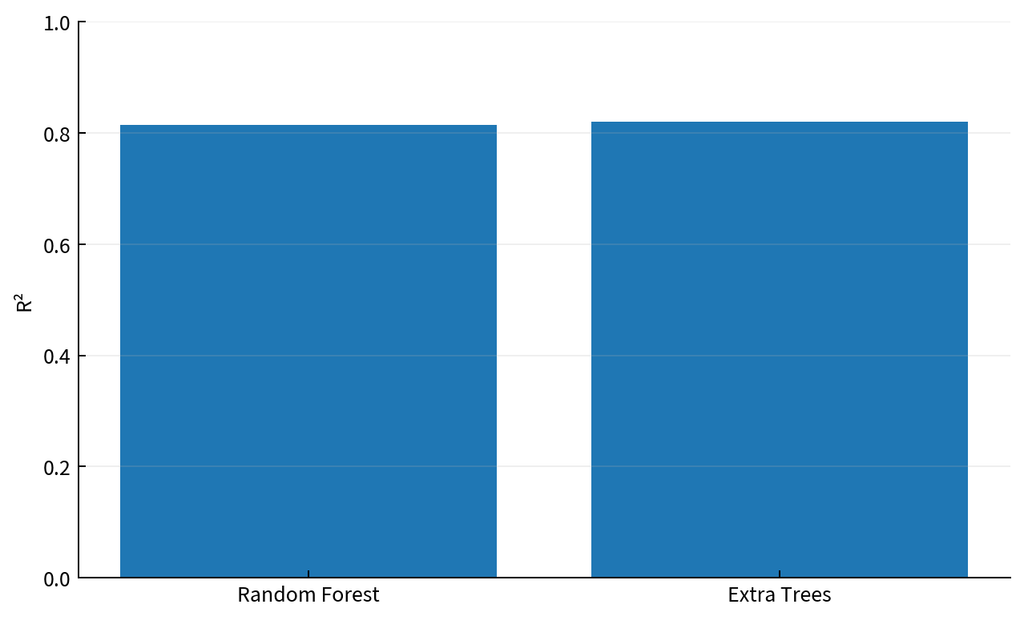
本記事の人工データに対する結果であり、他のデータで同じ順位になることを意味しません。
特徴量重要度を比較する
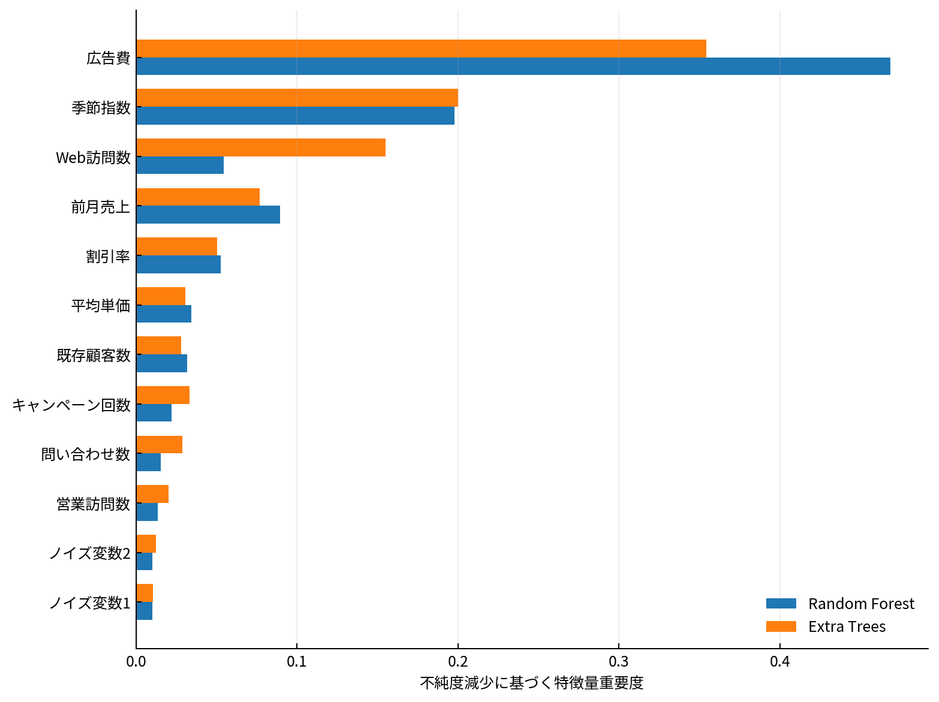
次に、両モデルのfeature_importances_を比較します。今回の人工データでは平均的な重要度上位に広告費、季節指数、Web訪問数、前月売上、割引率などが入りました。ただし、Random ForestとExtra Treesでは木の作り方が異なるため、同じデータでも重要度の配分は一致しません。
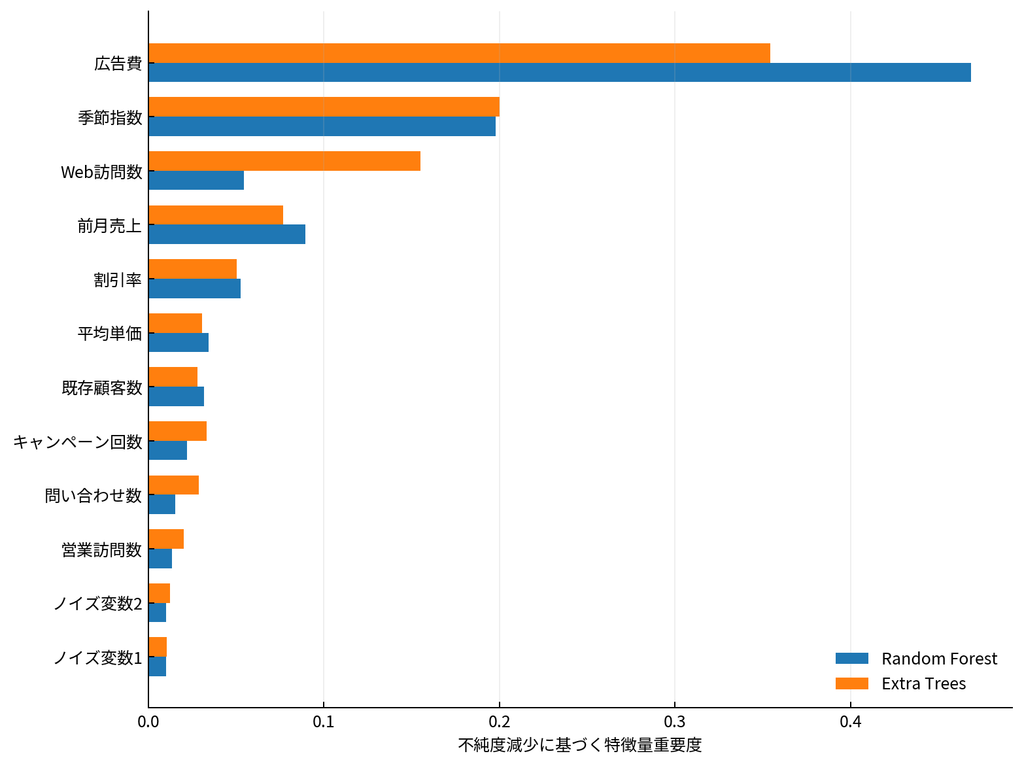
重要度はモデル内部で分割にどの程度寄与したかを見る参考値であり、業務上の重要性や因果効果を直接表すものではありません。
特に、不純度減少に基づく特徴量重要度は、ユニーク値が多い特徴量などを高く評価しやすいことが知られています。さらに学習データ上の分割統計から計算されるため、未知データでの有用性と完全に一致するわけではありません。したがって、本記事では「どちらのモデルがどの変数を相対的に使ったか」を見る補助情報として扱います。
比較結果から何が分かるか
Extra Treesが常に速いとは限らない
今回の条件ではExtra Treesの学習時間が短くなりました。分割しきい値の探索をランダム化する設計は計算時間を抑える方向に働き得ます。しかし、処理時間はモデルのアルゴリズムだけで決まりません。木の成長の仕方、データ件数、特徴量の型、並列化、メモリ、CPUキャッシュなど複数の要因が関係します。
実務では学習時間だけでなく、予測時間、再学習頻度、データ前処理にかかる時間まで含める必要があります。毎日再学習するモデルと四半期に一度しか更新しないモデルでは、数秒の学習時間差の重要性は大きく異なります。
精度差が小さい場合はどう判断するか
今回のMAEとR²の差は小さく、精度だけで強い優劣を付ける結果ではありません。このような場合、異なるデータ分割でも傾向が維持されるか、誤差の大きいケースに違いがないか、計算資源や再学習時間に実務上の差があるかなどを確認します。
また、売上予測でMAEがわずかに改善しても、在庫発注量や営業計画が変わらなければ、その差は意思決定上重要でないかもしれません。評価指標を「モデルを競わせる数字」ではなく、「業務判断に必要な精度を測る数字」として設計することが重要です。
特徴量重要度の順位が変わる理由
Random ForestとExtra Treesでは各木の分割規則が異なるため、ある特徴量が選ばれる回数や不純度減少への寄与も変わります。相関する特徴量が複数あれば、一方のモデルでは特徴量Aが多く使われ、もう一方では特徴量Bへ重要度が分散することもあります。
この違いは「どちらかの重要度が正しい、もう一方が間違い」という意味ではありません。特徴量重要度はモデル依存の指標であることを前提に、予測性能や業務知識と組み合わせて読む必要があります。
モデル選択で見るべきポイント
Random ForestとExtra Treesの使い分け
Random Forestを候補にしやすいケース
- Random Forestの運用実績や既存コードがすでにある
- ブートストラップ標本を使う設計を維持したい
- out-of-bag評価を利用したい
- Random Forestを基準モデルとして他手法と比較したい
Random Forestは広く利用されているため、既存システム、監視指標、チューニング知識、説明資料が蓄積している組織では、わずかな性能差だけで置き換えない方が合理的な場合があります。
Extra Treesを候補にしやすいケース
- Random Forestと同系統の木アンサンブルで別のランダム化戦略を比較したい
- 多数の木を学習する際に計算時間も評価したい
- Random Forestと同程度の実装負荷で追加の候補モデルを用意したい
- 表形式データで非線形性や相互作用を扱うモデル候補を増やしたい
Extra Treesはscikit-learn上でRandom ForestとAPIが近いため、比較モデルとして追加しやすい点は実務上の利点です。ただし、追加しやすいことと採用すべきことは別です。実データでの検証結果を見て判断します。
最終的には同じ検証条件で比較する
モデル選択で避けたいのは、Random Forestだけ十分にチューニングし、Extra Treesは既定値のまま比較する、あるいはモデルごとに異なるテストデータを使うといった比較です。比較するなら、同じデータ分割、同じ評価指標、同じ業務上の判定基準を使う必要があります。
一方、ハイパーパラメータを完全に同じ値にすれば公平というわけでもありません。アルゴリズムごとに適切な値が異なるため、本格的なモデル選定では各モデルについて交差検証などで候補を探索し、その後、未使用のテストデータで最終評価する設計が望まれます。
実務で使う際の注意点
学習時間の測定条件をそろえる
学習時間を比較する場合は、n_jobs、木の本数、データ件数、計測回数、実行環境をそろえます。特に並列処理を有効にすると、他のプロセスの負荷やCPUコア数の影響を受けます。記事や検証資料で秒数を示す場合は、測定条件も一緒に残しておくと再現性が高まります。
random_stateを固定する
Random ForestもExtra Treesも乱数を利用するため、比較検証ではrandom_stateを固定して再現できる状態にします。ただし、本番での頑健性を確認するときは、乱数種を複数変えて性能のばらつきを見ることも有効です。
n_estimatorsなどの条件を合わせる
木の本数が100本と1,000本では、学習時間も予測の安定性も変わります。単純な速度比較ではn_estimatorsなどの基本条件を合わせます。その上で、本格運用前には各モデルに適した値を探索します。本記事では両者とも300本とし、木の本数による差が速度比較へ直接入りにくいようにしています。
特徴量重要度を因果効果と解釈しない
特徴量重要度が高い変数を見て、「この施策を増やせば売上が上がる」と結論づけることはできません。予測モデルは観測データのパターンを利用しており、施策の因果効果を直接推定する設計ではありません。さらに、不純度ベースの重要度には指標固有の偏りもあります。
時系列データではランダム分割に注意する
今回の人工データではモデルの違いを見やすくするためランダムなtrain/test分割を使いました。しかし、月次売上や需要予測のように時間順序がある実データでは、未来の情報が学習データへ混ざらないよう、時間順に学習期間と評価期間を分ける必要があります。
また、データクレンジング、特徴量作成、欠損値処理などを全データに対して先に行うと、テストデータの情報が学習側へ漏れる場合があります。比較対象がRandom ForestかExtra Treesかにかかわらず、前処理を含めた評価手順を分離しておくことが重要です。
実務ではモデル選択より先に評価設計を決める
Random ForestとExtra Treesのコード比較は難しくありません。むしろ実務で難しいのは、「何を予測するか」「どの時点のデータを使えるか」「どの誤差を重要とするか」「予測をどの業務判断へ使うか」を決めることです。
例えば同じ売上予測でも、在庫量を決める用途と営業人員を配置する用途では許容誤差や予測粒度が変わります。MAEが小さいモデルを選んでも、必要なタイミングまでにデータがそろわない、説明変数が本番では取得できない、予測値が意思決定に結びつかないのであれば実用性は下がります。
さらに、評価期間が繁忙期だけに偏っている、学習データに制度変更前のデータが大量に含まれている、商品構成が変化しているといった状況では、単純な平均スコアだけでは実運用時の性能を判断しにくくなります。モデルそのものだけでなく、データの代表性や評価期間の選び方まで含めて設計する必要があります。
SCI総合研究所株式会社のRASHINRAでは、売上・営業・マーケティング・業務データなどを対象に、分析目的の整理、データ設計、複数モデルの比較、結果の解釈、意思決定への活用までを支援しています。Random ForestとExtra Treesのどちらを使うかという問いも、モデル名からではなく、最終的に何を判断するための分析なのかから整理することが重要です。
まとめ:Extra TreesはRandom Forestと並べて検証する価値のある選択肢
Extra Treesは、Random Forestと同じく複数の決定木を組み合わせるアンサンブル学習ですが、分割しきい値にも強いランダム性を導入する点が特徴です。scikit-learnの既定設定ではbootstrapの扱いにも違いがあります。
- Random ForestもExtra Treesもランダム化された複数の決定木を集約する
- Extra Treesでは分割しきい値もランダムに生成する
- scikit-learnではRandom Forestはbootstrap=True、Extra TreesはFalseが既定
- どちらが高速・高精度かはデータと設定によって変わる
- 学習時間は複数回測定し、評価条件を明示する
- 特徴量重要度は因果効果や業務上の重要性と同一視しない
- 実務ではMAEやR²だけでなく、計算コストや意思決定への利用方法まで含めて選ぶ
今回の人工データではExtra Treesの方が学習時間が短く、MAEとR²もわずかに良い結果でした。しかし、これは2,400件の人工データと今回の設定に対する結果です。Random ForestとExtra Treesの関係を「勝ち負け」で覚えるより、同じ評価設計の中で比較し、利用目的に合うモデルを選ぶことが実務では重要です。
アンサンブル学習やバギングの位置づけから整理したい場合は、SCI-Naviの「勾配ブースティングとバギングの違いとは?理論・メリット・デメリットをビジネス視点で解説」もあわせてご覧ください。
参考文献
- Breiman, L. 2001. Random Forests. Machine Learning. Vol. 45. pp. 5-32. https://doi.org/10.1023/A:1010933404324
- Geurts, P., Ernst, D. and Wehenkel, L. 2006. Extremely randomized trees. Machine Learning. Vol. 63. Issue 1. pp. 3-42. https://doi.org/10.1007/s10994-006-6226-1
- Pedregosa et al. 2011. Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research. Vol. 12. No. 85. pp. 2825-2830. https://www.jmlr.org/papers/v12/pedregosa11a.html