
社内ヘルプデスクや情報システム部門では、問い合わせメールやチケットを「障害」「アカウント」「セキュリティ」などへ分類し、担当者へ振り分ける作業が発生します。件数が増えると、分類そのものに時間がかかるだけでなく、担当者によってカテゴリの判断が揺れることもあります。
こうした文章分類で利用できる代表的な手法の一つがNaive Bayes(ナイーブベイズ)です。Naive Bayesはベイズの定理を基礎とし、クラスが与えられた条件下で各特徴量が独立であるという単純化した仮定を置く分類手法です。文章分類では古くから利用されており、単語や文字列の出現回数を特徴量とするMultinomial Naive Bayesは代表的な構成です(Manning et al., 2008)。
本記事では、実在企業とは無関係の人工的なIT問い合わせ500件を用意し、Pythonのscikit-learnで「アカウント」「障害」「セキュリティ」の3カテゴリへ分類します。日本語の形態素解析環境を追加せずに再現できるよう、文章は文字n-gramへ変換し、MultinomialNBで学習します。Accuracyだけではなく、Precision、Recall、F1、混同行列、実際に誤分類された文章まで確認します。
目次
- Naive Bayesとは
- Naive Bayesで文章をどう分類するのか
- Multinomial Naive Bayesとは
- IT問い合わせ500件の人工データを作る
- 日本語文章を文字n-gramへ変換する
- PythonでNaive Bayesによる問い合わせ分類を実装する
- 分類結果をAccuracyだけで評価しない
- どのような問い合わせを誤分類したのか
- モデルがカテゴリ別に学習した文字列を確認する
- 新しい問い合わせを分類してみる
- Naive Bayesを問い合わせ管理へ使う際の注意点
- Naive Bayesをどこまで自動化へ使うか
- まとめ:Naive Bayesは問い合わせ一次分類のベースラインとして使いやすい
- 参考文献
Naive Bayesとは
ベイズの定理を使った分類手法
ベイズの定理では、ある特徴が観測されたときに、そのデータが特定のクラスへ属する確率を考えます。文章分類であれば、「この問い合わせに『不審』『ログイン』『通知』といった文字列が含まれているとき、セキュリティ問い合わせである可能性をどう評価するか」という問題に対応します。
Naive Bayesでは、クラスyと特徴量x₁, x₂, ...について、概念的にはP(y | x) ∝ P(y) × P(x₁ | y) × P(x₂ | y) × ...という形で各クラスのスコアを求め、最も大きいクラスを予測します。P(y)は事前確率、P(xᵢ | y)はクラスが与えられたときの特徴量の尤度に対応します(Manning et al., 2008)。
「Naive」と呼ばれる理由
Naive Bayesが「naive(単純な)」と呼ばれるのは、クラスが与えられた条件下で特徴量同士が条件付き独立であると仮定するためです。文章では「不審」と「メール」、「パスワード」と「ログイン」のように、実際には互いに関係する語や文字列が数多く存在します。したがって、「文章中の単語は本当に独立している」と説明するのは正確ではありません。
この仮定は現実の文章生成過程を忠実に表したものではありませんが、Naive Bayesはテキスト分類で長く使われてきました。一方、特徴量依存やクラス不均衡など、単純な仮定に由来する弱点も知られています(Rennie et al., 2003)。そのため、実務では「単純だから使えない」「単純だから必ず高精度」のどちらでもなく、目的に対するベースラインとして性能と誤り方を確認する姿勢が重要です。
Naive Bayesで文章をどう分類するのか
機械学習モデルへ文章をそのまま入力するのではなく、まず文章を数値特徴量へ変換します。今回使用するCountVectorizerは、複数の文章からn-gramを抽出し、それぞれが文章中に何回出現したかを疎行列として表現します。
Multinomial Naive Bayesとは
Naive Bayesには複数の種類があります。今回使用するMultinomial Naive Bayesは、単語や文字列の出現回数のような非負の離散特徴量を扱う文章分類で代表的なモデルです。クラスごとに各特徴量がどの程度現れるかを学習し、その出現傾向を新しい文章の分類へ利用します。
alphaとラプラス平滑化
学習データ中で、あるカテゴリに特定の文字列が一度も登場しなかったとします。その出現確率を単純に0とすると、新しい問い合わせにその特徴量が1回含まれるだけでクラス全体の尤度が0になり得ます。そのためMultinomial Naive Bayesでは、出現回数へ小さな値を加える加法平滑化を使います。
scikit-learnのMultinomialNBではalphaが平滑化の強さを表し、alpha=1.0はラプラス平滑化に相当します。今回の記事では仕組みを明確にするため、デフォルトと同じ1.0を使用します。alpha自体を細かく最適化することは本記事の中心にはしません。
TF-IDFを使う場合
文章分類ではTF-IDFで重み付けした特徴量を使う方法もあります。Multinomial Naive Bayesの理論上はカウント特徴量が基本ですが、TF-IDFのような小数値も実務上利用されることがあります。本記事では、「どの文字列が何回現れたか」とモデルの関係を説明しやすくするため、CountVectorizerによるカウントを採用します。
IT問い合わせ500件の人工データを作る
人工データはアカウント200件、障害180件、セキュリティ120件の合計500件としました。完全均等にはせず、セキュリティ問い合わせを少なめにしています。この程度の不均衡でも、Accuracyだけを見るのではなくカテゴリ別のRecallやF1を見る意味があります。
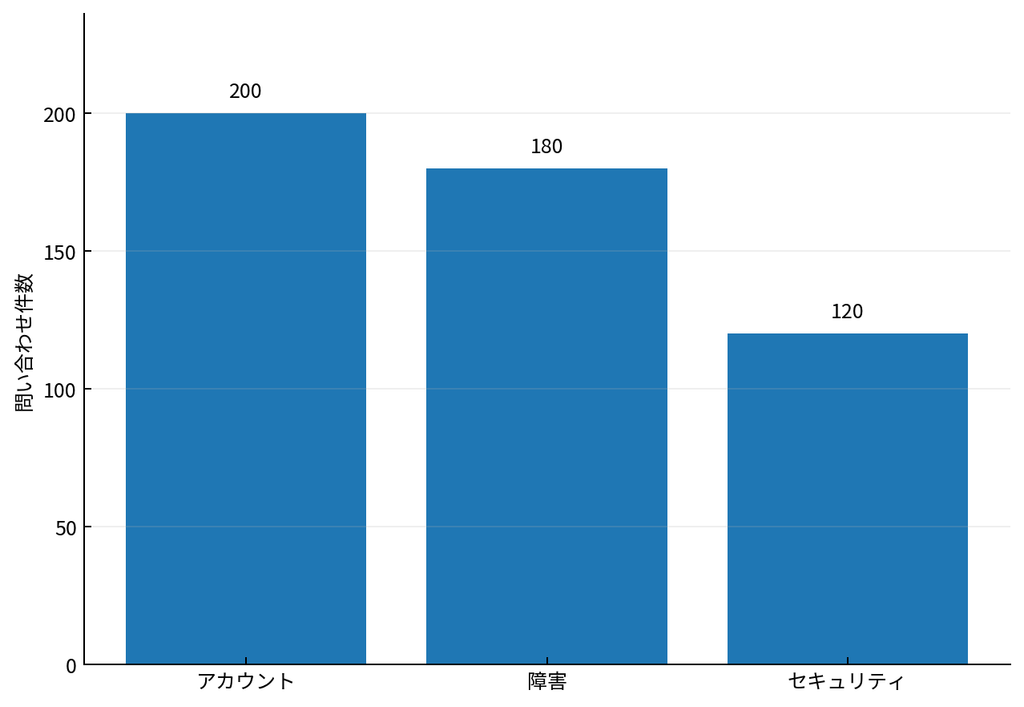
アカウント200件、障害180件、セキュリティ120件で構成しています。
| 問い合わせ文章 | カテゴリ |
|---|---|
| パスワードを忘れてログインできません | アカウント |
| VPNに接続できず社内システムへ入れません | 障害 |
| 不審なメールを受信しました | セキュリティ |
| システムへアクセスできません | 複数カテゴリに出現する曖昧表現 |
単純に「パスワード」という語があれば必ずアカウント、といったデータにはしていません。「ログインできません」「システムへアクセスできません」「メールの添付ファイルが開けません」「端末の警告が出ています」など、複数カテゴリで使われ得る曖昧な文章を約15%程度混ぜています。また、「VPNの認証でアカウントエラーが出る」「不審なログイン通知がある」など、他カテゴリの語彙を含む文章も入れています。
その結果、機械的なキーワード一致だけでは完全には分類できず、誤分類を評価する意味がある人工データになっています。なお、これは説明用に作った条件であり、500件あれば実案件でも十分という意味ではありません。
日本語文章を文字n-gramへ変換する
英語は空白で単語を区切りやすい一方、日本語では「パスワードを忘れました」のように単語間へスペースがありません。単語単位で厳密に処理する場合は日本語形態素解析を使う方法がありますが、今回は外部辞書や追加環境への依存を避けるため、文字n-gramを採用します。
analyzer="char"、ngram_range=(2, 4)とすると、2文字から4文字までの連続した文字列を特徴量候補にします。「アカウント」「不審」「接続エラー」などの一部が複数のn-gramに分解されます。この方法は日本語文章でもそのまま動かしやすい一方、生成される特徴量数は増えやすい点に注意が必要です。
今回の学習データ375件から、min_df=2を適用した後の特徴量数は1,950個でした。これは人工データで得られた具体値であり、実際の問い合わせデータでは語彙や文章長によって大きく変化します。
PythonでNaive Bayesによる問い合わせ分類を実装する
データは75%を学習用、25%をテスト用に分割しました。stratifyを指定し、アカウント・障害・セキュリティの比率が学習・テストで大きく変わらないようにしています。
from sklearn.pipeline import Pipelinefrom sklearn.feature_extraction.text import CountVectorizerfrom sklearn.naive_bayes import MultinomialNBmodel = Pipeline([ ("vectorizer", CountVectorizer( analyzer="char", ngram_range=(2, 4), min_df=2 )), ("classifier", MultinomialNB(alpha=1.0))])model.fit(X_train, y_train)pred = model.predict(X_test)PipelineへCountVectorizerとMultinomialNBをまとめることで、学習データから語彙を作る処理と分類器の学習を一体として扱えます。テストデータを使って語彙を事前生成することを避けやすく、実装上も扱いやすい構成です(Pedregosa et al., 2011)。
from sklearn.metrics import ( accuracy_score, f1_score, classification_report, confusion_matrix)print("Accuracy:", accuracy_score(y_test, pred))print("Macro F1:", f1_score(y_test, pred, average="macro"))print(classification_report(y_test, pred))labels = ["アカウント", "障害", "セキュリティ"]cm = confusion_matrix(y_test, pred, labels=labels)分類結果をAccuracyだけで評価しない
テストデータ125件に対するAccuracyは0.896、Macro F1は0.896でした。人工データとしては極端に低い性能ではありませんが、約10%は誤分類されています。そのため、全体の正解率だけでなく「どのカテゴリをどこへ間違えたか」を確認します。
| カテゴリ | Precision | Recall | F1 | 件数 |
|---|---|---|---|---|
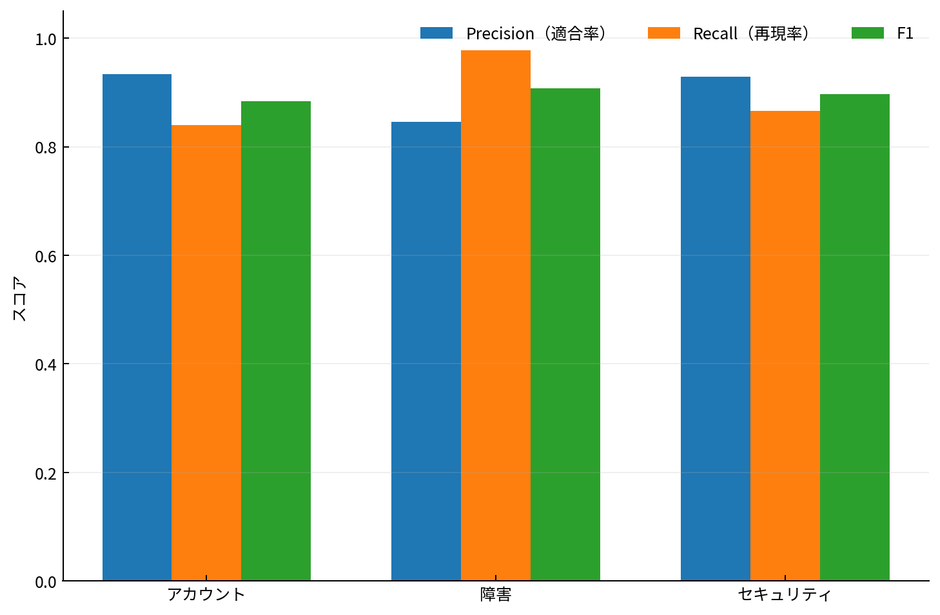
| アカウント | 0.933 | 0.840 | 0.884 | 50 |
| 障害 | 0.846 | 0.978 | 0.907 | 45 |
| セキュリティ | 0.929 | 0.867 | 0.897 | 30 |
セキュリティカテゴリではPrecisionが0.929、Recallが0.867、F1が0.897でした。Recall 0.867は、今回のテストデータに含まれるセキュリティ問い合わせ30件のうち26件をセキュリティとして検出し、4件を別カテゴリへ分類したことに対応します。
セキュリティ問い合わせの見逃しコストが高い業務ではRecallを重視する設計が候補になります。ただし、Recallだけを最大化すればよいわけではありません。セキュリティでない問い合わせを大量にセキュリティへ振り分ければ担当者負荷が増えるため、Precisionとのバランスや運用体制も確認します。
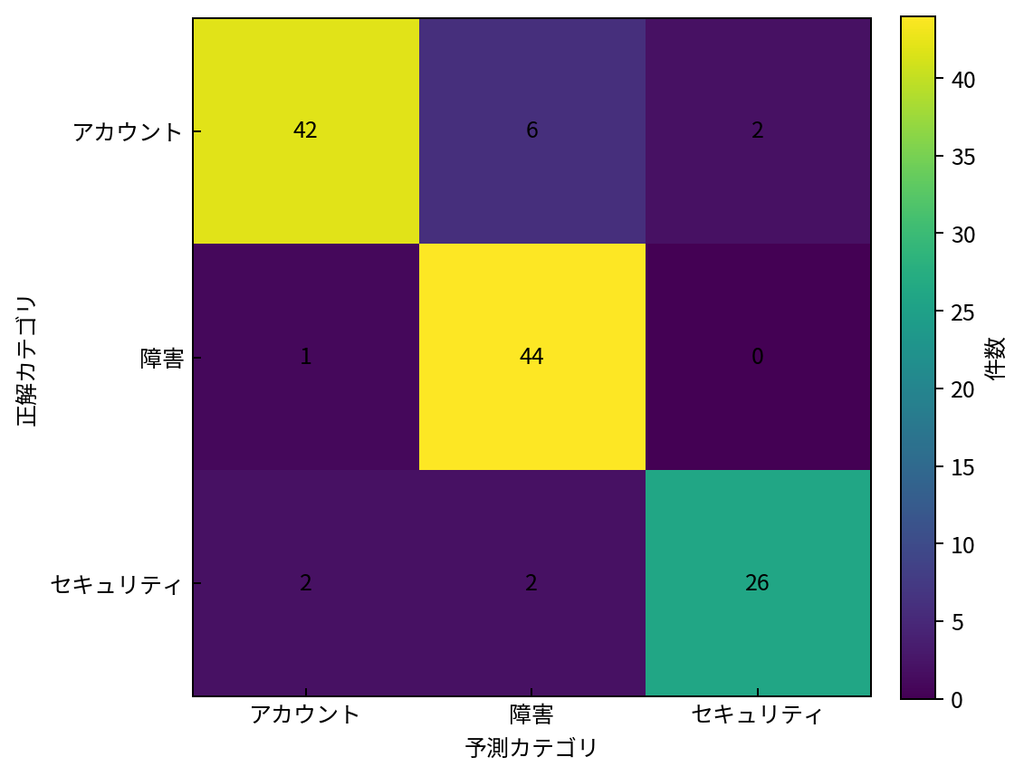
行が正解カテゴリ、列が予測カテゴリです。対角成分は正しく分類された件数、対角以外は誤分類を示します。
今回の混同行列では、アカウント50件中42件、障害45件中44件、セキュリティ30件中26件が正しく分類されました。セキュリティ4件の誤分類先はアカウント2件、障害2件です。このように混同行列を見ると、単一のAccuracyでは分からない「どの誤りが発生しているか」を確認できます。
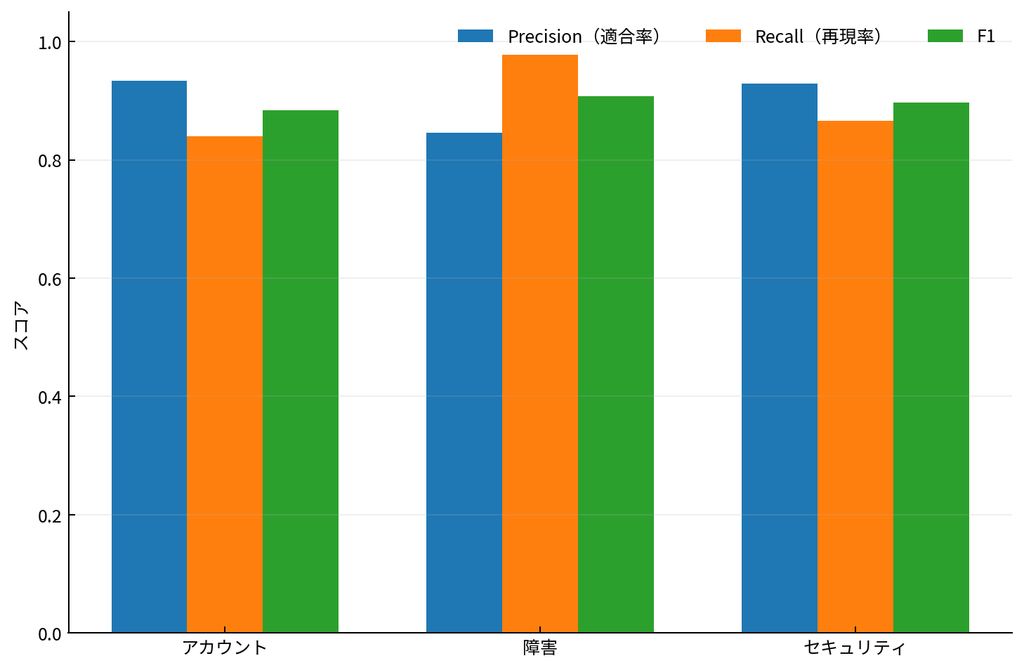
カテゴリごとの性能差を比較できます。
どのような問い合わせを誤分類したのか
今回のテストデータでは13件が誤分類されました。重要なのは、単に13件という数だけでなく、文章のどの曖昧さが分類を難しくしたかを見ることです。
| 問い合わせ文章 | 正解 | 予測 |
|---|---|---|
| お疲れさまです。メールの添付ファイルが開けません。対応をお願いします。 | セキュリティ | 障害 |
| 今朝からメールの添付ファイルが開けません | アカウント | 障害 |
| 先ほどからメールの添付ファイルが開けません。念のため確認してください。 | アカウント | 障害 |
| 昨日からシステムへアクセスできません。業務に影響しています。 | アカウント | 障害 |
| 利用者から連絡があり、端末の警告が出ています。業務に影響しています。 | アカウント | 障害 |
| お疲れさまです。メールの添付ファイルが開けません。どうすればよいでしょうか。 | アカウント | 障害 |
| お疲れさまです。ログインできません。業務に影響しています。 | 障害 | アカウント |
| 利用者から連絡があり、アカウントがロックされました。念のため確認してください。 | アカウント | セキュリティ |
「メールの添付ファイルが開けません」は、人工データ上ではアカウント・障害・セキュリティの複数カテゴリに含めています。文章だけを見ると、ファイル障害なのか、権限制御なのか、不審な添付ファイルなのかが分かりません。このような問い合わせは、モデルの改善以前に追加情報を取得する運用が必要です。
「ログインできません」も同様です。通常のパスワード忘れならアカウント、認証基盤の障害なら障害、身に覚えのない認証通知が同時にあればセキュリティとなる可能性があります。実業務では、本文だけでは分類できない問い合わせを無理に自動確定せず、「要確認」へ送る設計も考えられます。
モデルがカテゴリ別に学習した文字列を確認する
MultinomialNBでは、各カテゴリについて文字n-gramの出現傾向が学習されます。今回のモデルで他カテゴリとの差が比較的大きかった文字列から、説明しやすい代表例を抜き出すと、アカウントでは「変更」「権限」「ロック」、障害では「起動」「接続」「印刷」、セキュリティでは「通知」「不審」「怪しい」などが確認できました。
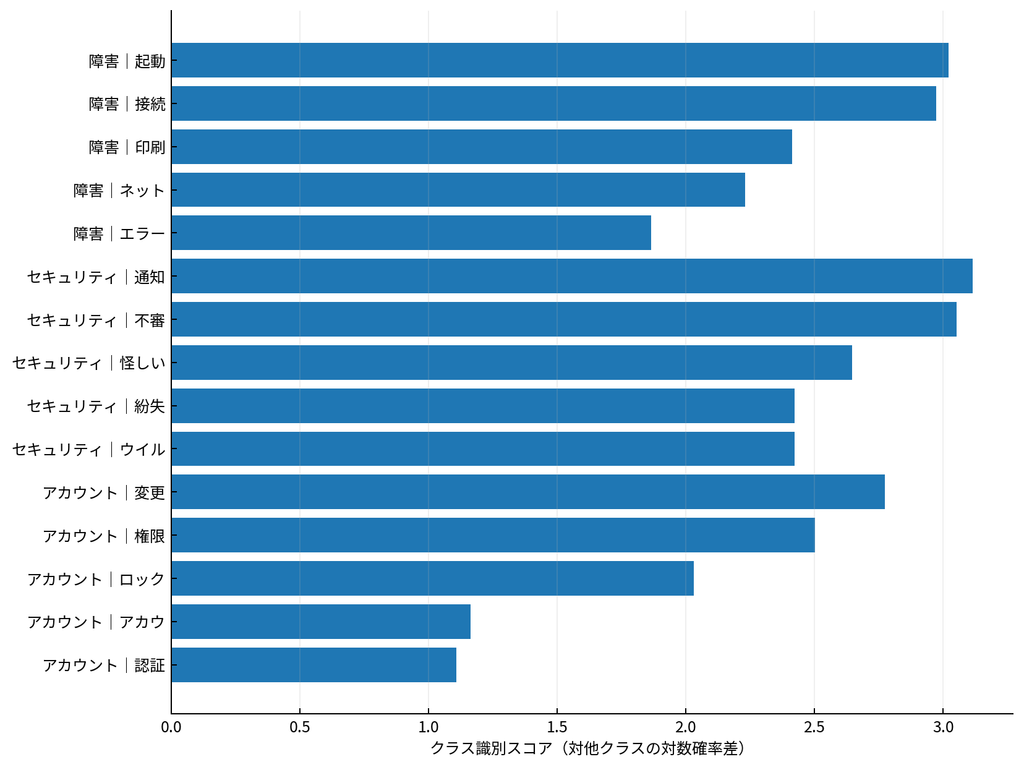
横軸は、そのカテゴリの対数特徴確率から他カテゴリ平均を引いた説明用スコアです。因果的重要度ではなく、今回の人工データにおける分類上の傾向を示しています。
ここにも注意があります。学習データに「至急」「お願いします」といった文体上の癖がカテゴリごとに偏っていれば、モデルは業務内容ではなく書き方を学習する可能性があります。文章分類では、カテゴリラベルの品質だけでなく、部署ごとのテンプレートや入力ルールの偏りも確認する必要があります。
新しい問い合わせを分類してみる
new_texts = [ "パスワードを忘れてサインインできません", "VPN接続時にエラーが表示されます", "身に覚えのないログイン通知が届きました"]model.predict(new_texts)学習済みPipelineへ新しい文章を渡せば、同じ文字n-gram変換を経て予測カテゴリを取得できます。しかし、実運用でこの結果をそのまま担当部署へ自動送信する設計には慎重さが必要です。分類モデルは未知の表現、カテゴリ定義の変更、システム名の追加などによって性能が変化します。
また、predict_probaで確率形式の値を取得できますが、Naive Bayesは分類器として有用でも確率推定器としては過信すべきでないことが知られています。例えば「0.90だから90%の確信度で安全に自動処理できる」と直接解釈せず、必要なら確率校正や別の検証を行い、業務上の閾値は誤分類コストと合わせて設計します。
Naive Bayesを問い合わせ管理へ使う際の注意点
カテゴリ定義とラベル品質を先に整える
モデルは過去データのラベルを正解として学習します。同じ「システムへアクセスできない」という問い合わせを、担当者Aは障害、担当者Bはアカウントとして登録していれば、その曖昧さも学習データへ入ります。分類モデルを高度化する前に、「障害」「アカウント」「セキュリティ」の定義と境界を文章化することが重要です。
「その他」「要確認」を設ける
現実のIT問い合わせは3種類だけではありません。端末申請、ソフトウェア利用申請、操作方法、調達、設備など別カテゴリが存在する場合があります。また文章から判断できない問い合わせもあります。モデルへ必ず3カテゴリのどれかを選ばせるだけでなく、「その他」「要確認」をどのように扱うかを業務フローとして検討します。
問い合わせ文章そのものを情報資産として扱う
問い合わせ本文には、氏名、メールアドレス、端末名、IPアドレス、社内システム名、障害内容、アクセス権限、インシデント情報などが含まれる可能性があります。分類モデルの学習データとして再利用する場合も、利用目的、保存場所、アクセス権限、匿名化の要否、ログを整理する必要があります。
問い合わせ履歴のデータ整備については、SCI-Naviの「Excel・CSVの業務データはどこまで分析に使えるか」も関連します。また、AIで利用する社内データのアクセス権限や利用条件については「生成AI活用におけるAI-readyなデータとは?現場担当者が0ベースで始めるデータ整備」も参考になります。
Naive Bayesを使えば、文章分類モデルそのものは比較的少ないコードで実装できます。しかし、問い合わせ管理の実務では、分類モデルの前後にあるカテゴリ定義、権限、ログ、誤分類時の扱い、人手確認の方が重要になる場合もあります。モデル精度だけを目的にせず、業務フロー全体のどこを補助するのかを先に決める必要があります。
Naive Bayesをどこまで自動化へ使うか
今回の人工データではAccuracy 0.896という結果になりましたが、これは実業務で約90%を安全に自動処理できることを意味しません。誤分類された約10%の中に、セキュリティインシデントの初動に関係する問い合わせが含まれるかもしれないためです。
実務での利用方法としては、例えば「担当者画面へ推奨カテゴリを表示する」「通常問い合わせの一次振り分け候補として使う」「分類結果と人手修正をログへ残す」といった補助用途から検証する方が現実的です。セキュリティカテゴリや分類不能な問い合わせについては、人手確認を必須とする運用も考えられます。
つまり、問い合わせ分類では「どのモデルを使うか」だけでなく、どこまでモデルに判断させ、どこから人へ戻すかが設計上の重要点です。分類モデルの改善と、IT運用・セキュリティ設計は分離せずに検討する必要があります。
まとめ:Naive Bayesは問い合わせ一次分類のベースラインとして使いやすい
- Naive Bayesはベイズの定理を基礎とする教師あり分類手法である
- クラスが与えられた条件下で特徴量が独立であるという単純化した仮定を置く
- 文章分類ではMultinomial Naive Bayesが代表的な選択肢になる
- 日本語文章は文字n-gramを使えば形態素解析環境なしでも数値化できる
- alpha=1ではラプラス平滑化となり、未観測特徴量による確率0を避ける
- Accuracyだけでなくカテゴリ別Precision・Recall・F1と混同行列を確認する
- 今回の人工データではAccuracy 0.896、Macro F1 0.896だった
- セキュリティ問い合わせ30件のうち4件は別カテゴリへ誤分類された
- モデルの出力確率をそのまま業務上の信頼度として扱わない
- 実務ではカテゴリ定義、ラベル品質、情報管理、例外処理、人手確認まで含めて設計する
SCI総合研究所株式会社のKANAMEBAでは、社内IT・DX業務について、現状業務の整理、問い合わせ管理、データ・システム連携、アクセス権限、情報セキュリティ、運用ルールまで含めた設計を支援しています。文章分類モデルの導入自体を目的とせず、どこまで自動化し、どこを人が判断するかを含めてIT業務を整理したい場合はご相談ください。
参考文献
- Manning, C. D., Raghavan, P. and Schütze, H. 2008. Introduction to Information Retrieval. Cambridge University Press. pp. 234-265. https://doi.org/10.1017/CBO9780511809071
- Rennie, J. D. M. et al. 2003. Tackling the Poor Assumptions of Naive Bayes Text Classifiers. Proceedings of the Twentieth International Conference on Machine Learning. pp. 616-623. https://cdn.aaai.org/ICML/2003/ICML03-081.pdf
- Pedregosa et al. 2011. Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research. Vol. 12. pp. 2825-2830. https://www.jmlr.org/papers/v12/pedregosa11a.html